오늘날 인프라는 코드로 작성되고, 버전 관리 시스템에 저장되며, 자동화된 파이프라인을 통해 배포됩니다. IaC(Infrastructure as Code, 코드형 인프라)는 인프라의 원하는 상태를 코드로 선언하고, 도구가 그 상태를 실제 환경에 자동으로 구현하는 방식입니다. 이번 글에서는 IaC가 등장한 배경과 함께 선언적인 인프라와 절차적인 인프라라는 두 가지 접근 방식을 살펴보고, 각 방식의 대표 도구가 코드로 적힌 인프라를 실제 프로비저닝으로 바꾸는 과정을 내부 구현 수준에서 들여다봅니다.
IaC의 등장 배경
왜 인프라를 코드로 관리한다는 아이디어가 등장했을까? 프로비저닝(Provisioning)을 수동으로 수행하면 몇 가지 근본적인 문제가 생긴다.
- 재현 불가능성: 같은 환경을 두 번 만들어도 어떤 설정을 빠뜨리거나, 버전이 달라지거나, 순서가 바뀌는 등 미묘한 차이가 발생한다. 이렇게 개발 환경과 프로덕션 환경이 달라지면 개발 환경에서는 잘 돌아가던 서비스가 프로덕션 환경에서는 돌아가지 않을 수도 있다.
- 감사 불가능성: 누가 언제 무엇을 바꿨는지 알 수 없다. 장애가 발생했을 때 최근 변경 사항을 추적하기 어렵다.
- 확장 불가능성: 서버 10개를 수동으로 만드는 것은 가능하지만, 100개는 비현실적이다. 클라우드 네이티브 환경에서 인프라는 수시로 생성되고 삭제된다.
IaC는 이 세 문제를 코드로 해결한다. IaC는 인프라를 정의하는 소스 코드이기 때문에 소프트웨어 개발에서 쓰는 도구와 관행을 그대로 적용할 수 있고, 버전 관리, 코드 리뷰, 자동화 테스트, CI/CD(Continuous Integration/Continuous Delivery, 지속적 통합/지속적 전달) 파이프라인이 인프라에도 동작한다. 『데브옵스 핸드북』은 한 걸음 더 나아가, 환경에는 애플리케이션 코드보다 몇 자릿수나 많은 설정 항목이 있으므로 버전 관리가 가장 필요한 대상은 오히려 환경이라고 말한다(Kim et al., 2021). 환경의 요구 사항이 문서나 누군가의 머릿속이 아니라 자동화된 환경 생성 과정 안에 코드로 담겨 있어야, 누구든 티켓을 열고 몇 주를 기다리는 대신 몇 분 만에 프로덕션과 같은 환경을 다시 만들 수 있다는 것이다.
선언적인 방식 vs 절차적인 방식
IaC 도구는 인프라를 기술하는 방식에 따라 두 가지로 나뉜다. 선언적인declarative 방식은 원하는 최종 상태를 기술한다. 스토리지, 네트워크, 컴퓨팅 인스턴스 등 코드로 있어야 하는 인프라의 상태를 선언하면 도구가 현재 상태와 비교해 필요한 변경을 스스로 결정한다. Terraform, AWS(Amazon Web Services, 아마존 웹 서비스) CloudFormation, Pulumi가 이 방식을 따른다. Pulumi나 AWS CDK(Cloud Development Kit, 클라우드 개발 키트)처럼 TypeScript, Python 같은 범용 프로그래밍 언어로 코드를 쓰는 도구도 있지만, 그 언어의 반복문과 조건문은 원하는 자원 목록을 만들어 내는 데 쓰일 뿐이다. Pulumi는 프로그램이 등록한 자원 목록을 엔진이 현재 상태와 비교하고, CDK는 코드를 CloudFormation 템플릿으로 합성synthesize한 뒤 비교를 CloudFormation에 맡긴다. 즉 선언적인지 절차적인지는 언어의 문법이 아니라 엔진이 무엇을 입력으로 받아 무엇을 비교하는가에 달려 있다. 선언적 방식의 핵심 장점은 멱등성idempotency, 즉 같은 코드를 여러 번 실행해도 결과가 동일하다는 것이다. 이미 서버 3개가 있는 상태에서 서버 3개를 정의한 코드를 다시 실행해도 추가 서버가 생기지 않는다.


그림 1. 선언적인 방식과 절차적인 방식의 차이.
반면 절차적인imperative 방식은 수행할 단계를 순서대로 적어놓는 방식으로 프로비저닝을 수행한다. Ansible의 플레이북이 대표적이다. 그래서 절차적 방식에서는 코드를 작성하는 인프라 담당자가 언제 실행해도 같은 결과가 나오도록 직접 보장해야 한다. 다만 뒤에서 보겠지만 앤서블의 태스크 하나하나는 state: present처럼 원하는 상태를 적는 모양이고, 현재 상태와의 비교도 도구가 대신해 준다. 실제 두 방식의 경계는 "명령을 적는가, 상태를 적는가"보다는 원하는 상태를 어느 범위에서 선언하고, 그 사이의 순서를 누가 정하는가에 가깝다. 이 경계가 정확히 어디에 그어지는지 확인하는 것이 이 글 후반부의 목표다.
그 밖의 분류 축
선언적·절차적 구분 외에도 IaC 도구를 가르는 축이 몇 가지 더 있다. 한 도구가 축마다 한쪽에 정확히 놓이는 것은 아니지만, 이 축들을 알아 두면 뒤에서 살펴볼 두 도구의 설계를 이해하기 쉬워진다.
| 축 | 두 갈래 | 테라폼 | 앤서블 |
|---|---|---|---|
| 변경을 가하는 방식 | 가변mutable: 실행 중인 자원을 그 자리에서 고친다 / 불변immutable: 새로 만들어 교체한다1 | 제자리 수정이 가능한 속성은 수정하고, 그렇지 않은 속성(예: 인스턴스의 부팅 이미지)이 바뀌면 교체한다 | 기본적으로 실행 중인 호스트를 그 자리에서 고친다 |
| 변경이 전달되는 방향 | 푸시push: 중앙에서 대상으로 밀어낸다 / 풀pull: 대상이 스스로 받아 간다 | 실행한 쪽이 클라우드 API(Application Programming Interface, 응용 프로그래밍 인터페이스)를 호출하는 푸시 | ansible-playbook은 푸시, ansible-pull은 풀 |
| 대상에 필요한 것 | 에이전트agent: 대상에 상주 프로그램을 설치한다 / 에이전트리스agentless: 이미 있는 통로만 쓴다 | 대상은 클라우드 API이므로 설치할 것이 없다 | sshd와 파이썬만 있으면 된다 |
| 다루는 층위 | 프로비저닝과 구성 관리 | 주로 프로비저닝 | 주로 구성 관리, 클라우드 모듈로 프로비저닝도 한다 |
표 1. 선언적·절차적 구분 외에 IaC 도구를 가르는 축.
Puppet이나 Chef처럼 관리 대상마다 에이전트를 설치해 두고, 에이전트가 주기적으로 중앙 서버에서 설정을 받아 가는(풀) 구성 관리 도구도 있다. 반대로 불변 인프라 패턴에서는 운영 환경을 직접 고치는 일이 아예 허용되지 않고, 변경은 버전 관리에 넣은 뒤 코드와 환경을 처음부터 다시 만드는 방식으로만 반영된다(Kim et al., 2021). 이렇게 되면 구성 관리 도구가 하던 일의 상당 부분이 서버 이미지를 만드는 단계로 옮겨 간다.
이제 선언적 방식과 절차적 방식의 IaC 도구를 각각 하나씩 살펴보며 어떻게 인프라가 코드로 관리될 수 있는지 그 숨은 내막을 들춰보자.
선언적 방식 - Terraform
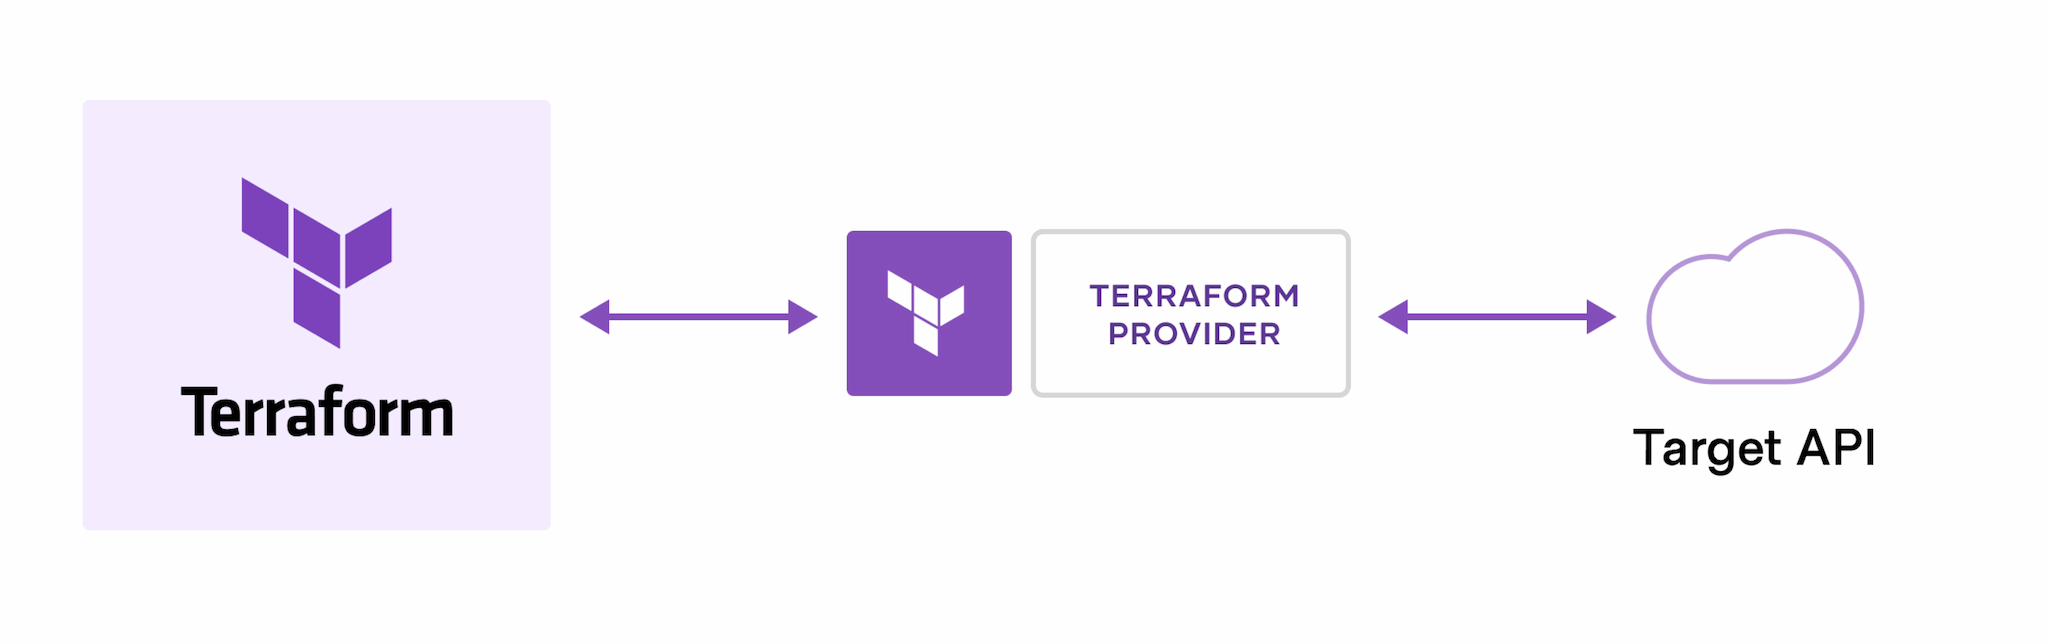
그림 2. 테라폼이 인프라를 프로비저닝하는 기본적인 실행 흐름. 테라폼은 프로바이더를 통해 실제로 인프라를 프로비저닝하는 프로바이더 측의 API를 사용한다.
테라폼(Terraform)은 HashiCorp가 만든 IaC 도구로, HCL(HashiCorp Configuration Language, 해시코프 설정 언어)이라는 선언적 언어를 사용한다.2 멀티 클라우드를 지원하며, AWS, GCP(Google Cloud Platform, 구글 클라우드 플랫폼), Azure, Kubernetes 등 수천 개의 프로바이더(provider)를 통해 다양한 인프라를 관리한다.3
기본 구조
테라폼으로 인프라를 정의하기 위해서는 테라폼 설정Terraform configuration이라는 문서를 작성해야 한다. 테라폼 설정은 수많은 파일과 디렉토리로 구성될 수 있으며, 테라폼이 관리해야 할 인프라를 정의한다. 테라폼 설정의 모든 코드는 HCL로 작성되며, HCL을 구성하는 기본 요소는 블록, 인수Argument, 표현식Expression으로 이루어져 있다.
블록은 인프라에 대한 정의를 담기 위한 일종의 그릇 역할을 수행한다. 블록에는 유형과 라벨, 그리고 몸통이 있어서 인프라의 다양한 속성을 정리할 수 있다. 인수는 블록 안에서만 정의할 수 있으며, 어떤 값을 특정 이름에 할당한다. 표현식은 어떤 값을 나타내는 식의 형태로 되어 있다. AWS EC2(Elastic Compute Cloud, 일래스틱 컴퓨트 클라우드) 인스턴스를 정의하는 예시 코드를 살펴보자.
# 프로바이더 설정
provider "aws" {
  region = "ap-northeast-2"
}

# 리소스 정의
resource "aws_instance" "web" {
  ami           = "ami-0c9c942bd7bf113a2"
  instance_type = "t3.micro"

  tags = {
    Name = "web-server"
  }
}
provider 블록은 인프라를 제공하는 공급자인 프로바이더를 설정할 때 사용한다. resource 블록은 관리할 인프라 자원을 선언한다. "aws_instance"는 리소스 타입, "web"은 코드 내에서 이 리소스를 참조하는 이름으로 사용하지만 둘 다 라벨인 것은 동일하다. resource 블록 안에는 AMI(Amazon Machine Image, 아마존 머신 이미지), 인스턴스 타입(instance_type)과 같이 AWS EC2 인스턴스를 정의하기 위한 여러 인수가 선언되어 있다.
이렇게 테라폼 설정 문서를 통해 사용자는 인프라를 구성하는 절차 대신 원하는 인프라의 최종 상태를 정의하고, 실제 인프라가 거기에 맞게 만들어지기를 바란다.
상태 파일
테라폼에서는 관리 중인 인프라와 그 설정, 즉 현재 작업 중인 워크스페이스4의 상태를 통해 사용자가 정한 설정과 실제 리소스를 연결한다. 메타데이터를 추적해 실제 인프라와 테라폼 설정을 동기화하고, 대규모 인프라의 성능을 개선하기 위해서기도 하다. 이를 위해 워크스페이스의 상태를 나타내는 상태 파일state file인 terraform.tfstate에 현재 인프라 상태를 JSON(JavaScript Object Notation, 자바스크립트 객체 표기법)으로 기록한다.5 코드를 실행할 때 테라폼은 상태 파일과 실제 인프라를 비교해 어떤 변경이 필요한지 계산한다.
그림 3. 테라폼에서 상태 파일을 통해 인프라의 상태를 관리하는 실행 흐름. 상태 파일을 통해 테라폼과 실제 인프라 간의 차이를 좁힐 수 있다.
이때 팀 환경에서는 상태 파일을 S3(Simple Storage Service, 단순 스토리지 서비스) 같은 원격 저장소에 보관하고, 잠금locking으로 두 사람이 동시에 상태를 고치지 못하게 막는다. S3 백엔드라면 use_lockfile = true를 지정해 상태 파일 옆에 .tflock 접미사가 붙은 잠금 파일을 만드는 S3 네이티브 잠금을 쓴다.6 또한 상태 파일에는 리소스의 속성이 그대로 기록되므로 데이터베이스 비밀번호 같은 민감한 값도 평문으로 남을 수 있다. 원격 저장소의 암호화와 접근 권한을 코드 저장소보다 엄격하게 관리해야 하는 이유다.
핵심 워크플로우
terraform init    # 프로바이더 플러그인 다운로드
terraform plan    # 변경 계획 미리보기 (실제 변경 없음)
terraform apply   # 변경 적용
terraform destroy # 모든 자원 삭제
테라폼을 처음 사용할 때는 init을 사용한다. 이때 프로바이더와 연결하기 위한 플러그인을 다운로드한다. 변경 계획을 미리 볼 때는 plan을 사용한다. terraform plan은 실제 변경 없이 무엇이 생성되고 수정되고 삭제될지 미리 보여준다. 실제로 변경을 적용할 때는 apply를 사용한다. 코드 리뷰처럼 변경 계획을 검토한 뒤 apply를 실행하는 것이 안전한 관행이다. 모든 자원을 삭제할 때는 destroy를 사용한다.
실제 과정
사용자 입장에서 plan과 apply는 명령어 두 줄에 불과하지만, 그 안에서는 사용자가 요구하는 인프라를 실제로 프로비저닝하는 코드로 번역하는 과정이 담겨 있다. 결국 선언적 도구의 핵심은 바로 이 번역기에 있는 셈이다. 이제 핵심 워크플로우를 더욱 자세히 파고들기 위해 테라폼의 소스 코드7를 따라가며 HCL 문서 한 장이 실제 클라우드 자원이 되기까지의 과정을 단계별로 살펴보자.
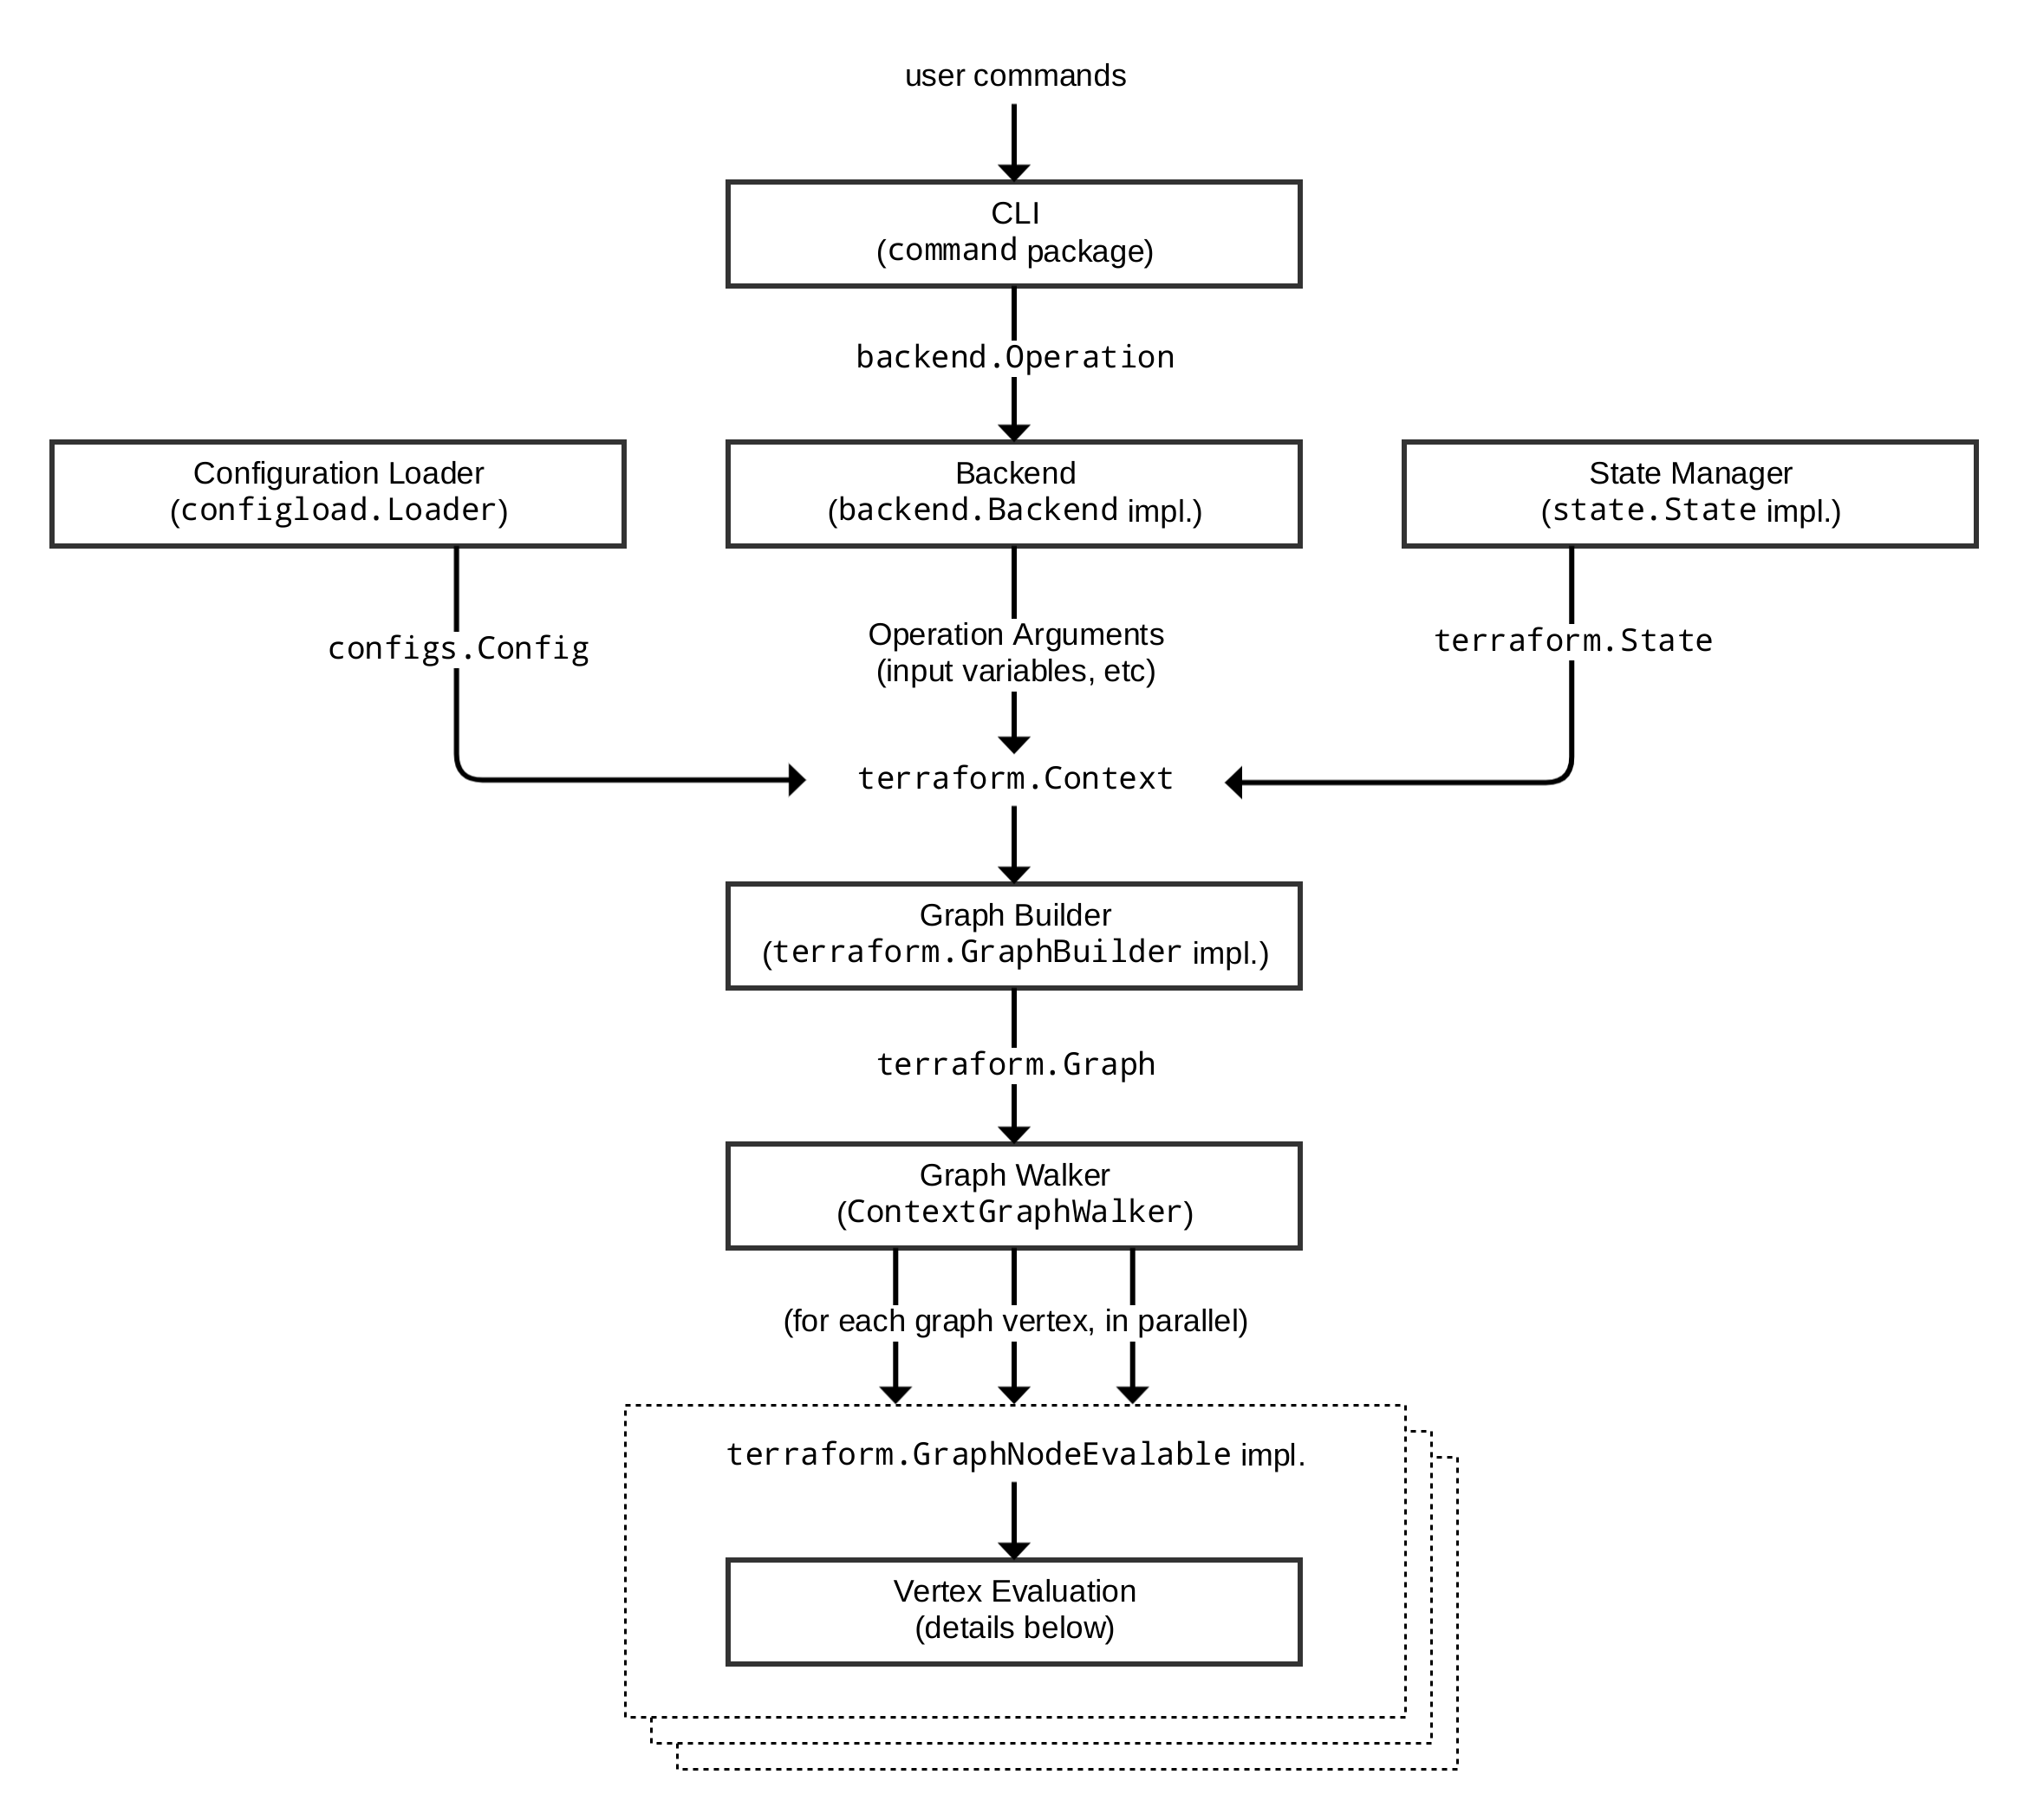
그림 4. 테라폼 코어의 요청 처리 흐름. 설정·상태·입력값이 terraform.Context로 모여 그래프가 되고, 그래프의 각 정점이 병렬로 평가된다. (출처: HashiCorp, Terraform Core Architecture Summary)
전체 과정을 요약하면 그림 4가 된다. 사용자가 입력한 명령은 CLI(Command Line Interface, 명령줄 인터페이스)를 거쳐 백엔드backend8에 하나의 작업operation으로 전달된다. 백엔드는 설정 로더configuration loader가 읽은 설정과 상태 관리자state manager가 읽은 상태를 terraform.Context에 넘기고, 컨텍스트는 이 둘을 재료로 그래프를 만든다. 그러면 그래프 워커graph walker가 그래프의 정점을 하나씩, 가능하면 동시에 평가한다. 실제 클라우드 API를 호출하는 일은 이 평가의 가장 마지막에, 그것도 테라폼 바깥의 프로그램이 맡는다.
코어와 프로바이더의 분리
테라폼 저장소의 README.md에는 이 저장소에 CLI와 그래프 엔진으로 이루어진 테라폼 코어Terraform core만 들어 있고, 프로바이더는 플러그인으로 구현된다고 적혀 있다. 실제로 AWS EC2 인스턴스를 만드는 코드는 이 저장소 어디에도 없다. 그 일은 hashicorp/aws 같은 프로바이더가 맡는데, 프로바이더는 테라폼 프로세스 안에서 불리는 라이브러리가 아니라 terraform init이 내려받는 별도의 실행 파일이다.
코어는 프로바이더가 필요해지면 그 실행 파일을 자식 프로세스로 띄우고 gRPC9로 통신한다. providerFactory가 바로 그 지점이다.
config := &plugin.ClientConfig{
	HandshakeConfig:  tfplugin.Handshake,
	AllowedProtocols: []plugin.Protocol{plugin.ProtocolGRPC},
	Managed:          true,
	Cmd:              exec.Command(execFile), // 프로바이더 바이너리를 자식 프로세스로 실행
	AutoMTLS:         enableProviderAutoMTLS,
	VersionedPlugins: tfplugin.VersionedPlugins,
	// ...
}

client := plugin.NewClient(config)
rpcClient, err := client.Client()
raw, err := rpcClient.Dispense(tfplugin.ProviderPluginName)
protoVer := client.NegotiatedVersion() // 플러그인 프로토콜 5 또는 6
연결이 맺어지면 코어와 프로바이더는 플러그인 프로토콜 버전 5와 6 중 서로 지원하는 버전을 협상하고, 이후의 모든 요청은 ReadResource, PlanResourceChange, ApplyResourceChange 같은 RPC로 오간다. 리소스의 속성 값은 프로바이더 스키마에서 유도된 타입에 맞춰 MessagePack10으로 직렬화되어 전달된다.
그림 5. 테라폼 코어가 프로바이더를 거쳐 API를 사용하는 과정을 조금 더 자세히 나타낸 그림.
이 분리가 선언과 실제 프로비저닝을 잇는 첫 번째 열쇠다. 코어는 리소스를 바꾸는 순서만 계산하고 그 변경을 어떤 API 호출로 실현하는가는 프로바이더에게 맡긴다. 덕분에 코어는 AWS API를 전혀 몰라도 되고, 새 플랫폼을 지원하려면 같은 인터페이스(providers.Interface)를 구현한 프로바이더를 하나 더 만들기만 하면 된다. 테라폼이 수백 개의 프로바이더를 거느릴 수 있는 이유가 여기에 있다.
1단계: 설정 해석
가장 먼저 테라폼은 작업 디렉터리의 .tf 파일을 모두 읽어 하나의 설정 객체로 만든다. internal/configs/parser.go의 LoadHCLFile이 확장자에 따라 HCL 네이티브 문법(.tf)과 JSON 문법(.tf.json) 중 하나로 파일을 파싱하면, parseConfigFile이 최상위 블록을 terraform, provider, variable, resource, data, module, moved 등의 유형에 따라 분류한다. 같은 디렉토리에 있는 파일들은 하나의 Module로 병합되고, 모듈들은 다시 부모-자식 관계를 갖는 트리인 configs.Config가 된다.
이 단계의 결과가 아직 정적인 설정이라는 점에 주의해야 한다. count = 3이라고 적힌 리소스도 이 시점에는 블록 하나일 뿐이고, 이를 인스턴스 세 개로 펼치는 일은 다음 단계의 그래프 순회 도중에 일어난다. 게다가 resource 블록 안의 인수도 이 단계에서는 해석되지 않는다. ami나 instance_type이 유효한 인수인지는 프로바이더만 알기 때문이다. 테라폼은 프로바이더에게서 받은 스키마를 디코딩 명세(configschema.Block.DecoderSpec)로 바꾼 뒤에야 블록 본문을 값으로 평가한다.
2단계: 그래프 구성
설정이 준비되면 terraform.Context는 작업 종류에 맞는 그래프 빌더graph builder로 그래프를 만든다. 계획 단계에서 쓰이는 PlanGraphBuilder는 빈 그래프에 30여 개의 변환기transformer를 차례로 적용하는 파이프라인이다. 각 변환기는 그래프를 받아 정점이나 간선을 더하고 빼는 일 하나만 맡는다. 그중 핵심적인 것을 추리면 다음과 같다.
| 변환기 | 하는 일 |
|---|---|
ConfigTransformer | 설정의 resource 블록마다 정점을 하나씩 만든다. |
OrphanResourceInstanceTransformer | 상태에는 있지만 설정에서 사라진 리소스 인스턴스, 즉 삭제할 대상의 정점을 만든다. |
ModuleExpansionTransformer | count·for_each가 적용된 모듈을 실제 인스턴스로 펼칠 정점을 만든다. |
ReferenceTransformer | 설정 안의 참조를 분석해 의존성 간선을 잇는다. |
CloseProviderTransformer | 프로바이더를 사용하는 모든 정점이 끝난 뒤 프로바이더 프로세스를 닫는 정점을 만든다. |
TransitiveReductionTransformer | 다른 경로로 이미 순서가 보장되는 중복 간선을 제거한다. |
여기서 간선을 더한다는 것은 보다 나중에 실행되어야 한다는 뜻이다. 그런데 ReferenceTransformer가 표현식 속 참조를 그대로 의존성으로 읽어내기 때문에 이 간선을 만들기 위해 사용자가 따로 순서를 적을 필요는 없다. 다음 설정을 보자.
resource "aws_vpc" "main" {
  cidr_block = "10.0.0.0/16"
}

resource "aws_subnet" "public" {
  vpc_id     = aws_vpc.main.id # VPC를 참조
  cidr_block = "10.0.1.0/24"
}

resource "aws_instance" "web" {
  ami           = "ami-0c9c942bd7bf113a2"
  instance_type = "t3.micro"
  subnet_id     = aws_subnet.public.id # 서브넷을 참조
}aws_subnet.public(AWS의 퍼블릭 서브넷)은 aws_vpc.main.id(AWS VPC(Virtual Private Cloud, 가상 사설 클라우드)의 ID)를, aws_instance.web(AWS의 EC2 인스턴스)은 aws_subnet.public.id(AWS 퍼블릭 서브넷의 ID)를 참조한다. 사용자는 VPC를 먼저 만들고 그다음 서브넷을 만드는 명령어를 쓴 적이 없지만, 참조 관계만으로 아래와 같은 실행 순서가 정해진다. 화살표는 실행 순서를 나타낸다.
그림 6. 테라폼에서 리소스를 변경하는 순서를 자동으로 생성한 결과. ID를 참조하는 방식을 통해 리소스를 변경하는 순서를 정하게 된다.
서로 참조하지 않는 리소스 사이에는 간선이 없으므로 이들은 동시에 처리될 수 있다. 또한 이렇게 만들어진 그래프는 DAG(Directed Acyclic Graph, 방향성 비순환 그래프)여야 한다. 순환 참조가 있으면 어느 쪽도 먼저 실행될 수 없으므로, 테라폼은 그래프를 검증하면서 Cycle:로 시작하는 오류를 내고 멈춘다. 사용자가 적은 것은 자원 사이의 관계뿐이고, 그 관계를 실행 순서로 바꾸는 일은 그래프가 대신한다.11
3단계: 그래프 순회
DAG가 완성되면 그래프 워커가 정점을 방문한다. internal/dag/walk.go의 워커는 정점마다 고루틴(goroutine)12을 하나씩 띄우고, 각 고루틴은 자신이 의존하는 정점들의 결과가 모두 나올 때까지 기다린다. 여기서 "결과가 나왔다"는 것은 성공만이 아니라 실패나 건너뜀까지 포함한다.
결과가 모두 나오면 워커는 그중 오류가 있는지 확인하고, 하나라도 실패했다면 자신의 작업을 실행하지 않은 채 upstream dependencies failed 오류를 남기고 끝낸다. 이 오류 때문에 그 정점에 의존하던 정점들도 차례로 건너뛰어지므로, 실패한 리소스에 의존하는 리소스는 모두 손대어지지 않은 채 남는다. 반면 실패한 정점과 의존 관계가 없는 정점은 영향을 받지 않고 그대로 실행된다.
이론상으로는 의존성이 풀린 정점이 모두 동시에 실행될 수 있지만, 실제로는 동시 실행 수에 상한이 있다. 정점의 실제 작업은 ContextGraphWalker.Execute를 거치는데, 여기서 세마포어를 얻어야만 작업을 시작할 수 있다.
func (w *ContextGraphWalker) Execute(ctx EvalContext, n GraphNodeExecutable) tfdiags.Diagnostics {
	// Acquire a lock on the semaphore
	w.Context.parallelSem.Acquire()
	defer w.Context.parallelSem.Release()

	return n.Execute(ctx, w.Operation)
}
세마포어의 크기는 NewContext에서 정해지며 기본값은 10이다. 소스 코드의 주석에 의하면 이 제한은 CPU 부하를 줄이는 동시에 프로바이더 API의 요청 수 제한rate limit에 걸리지 않기 위한 안전장치며, 이 값은 terraform plan -parallelism=N이나 terraform apply -parallelism=N으로 바꿀 수 있다. 계획과 적용이 같은 그래프 워커를 쓰기 때문에 두 명령이 같은 옵션을 공유한다(internal/command/arguments/extended.go).
4단계: 리소스 단위 계획
그래프 순회 중 리소스 정점의 차례가 오면 비로소 "현재 상태와 원하는 상태의 차이"가 계산된다. 이 계산은 리소스 인스턴스 하나마다 독립적으로 일어나며, 그 과정에서 프로바이더와의 RPC가 여러 차례 오간다.
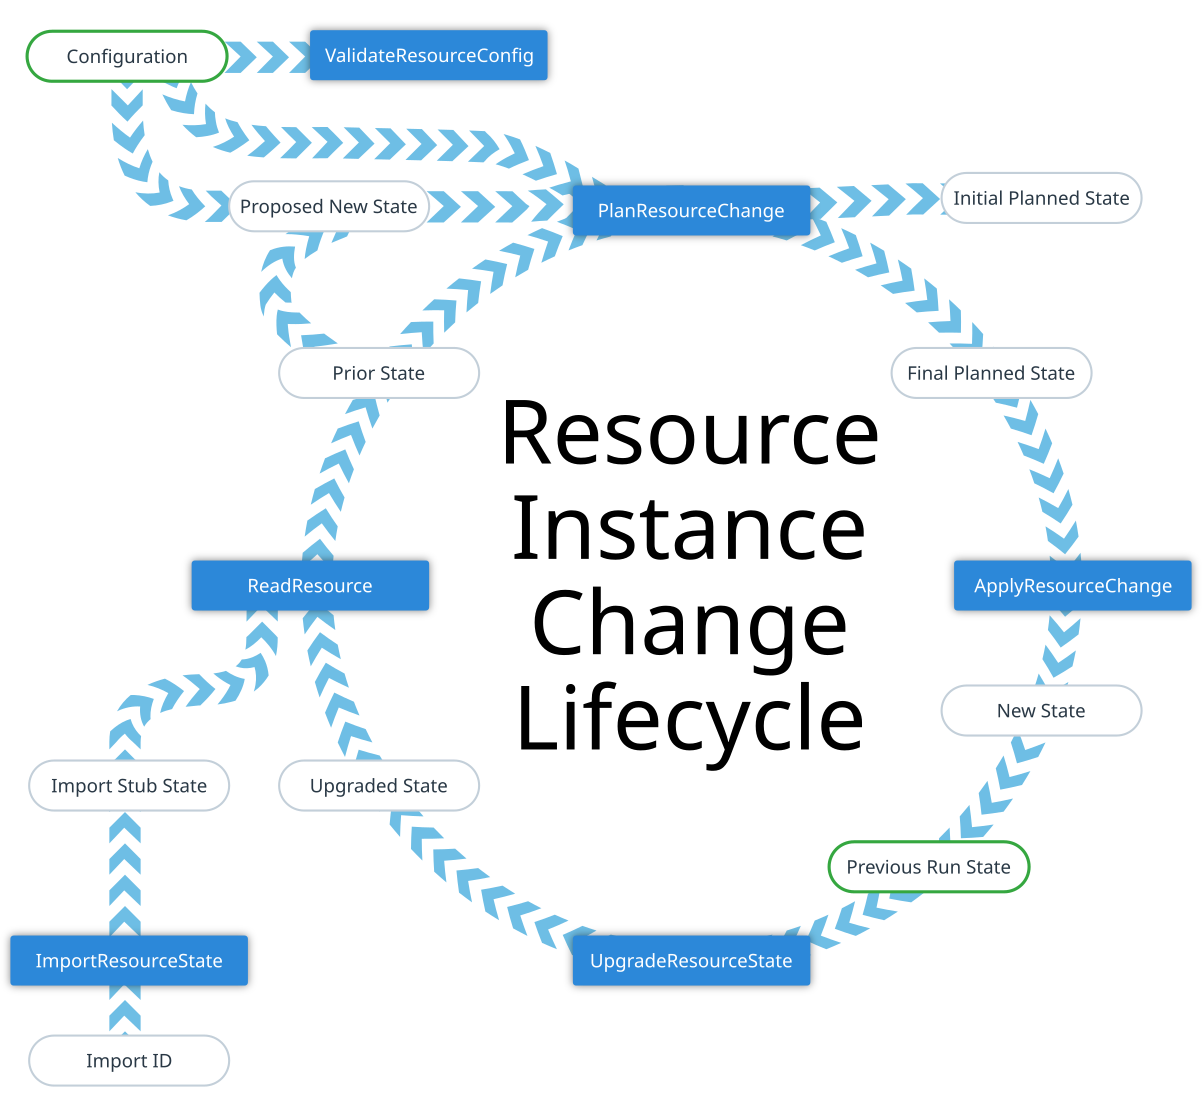
그림 7. 리소스 인스턴스 변경의 생애 주기. 파란 상자는 코어가 프로바이더에 보내는 RPC 통신이고, 흰 타원은 그 사이를 오가는 값이다. (출처: HashiCorp, Terraform Resource Instance Change Lifecycle)
그림 7의 왼쪽 위에서 출발해 시계 방향으로 따라가 보자.
- 새로고침refresh: 상태 파일에 기록된 지난 실행의 결과(Previous Run State)를 프로바이더의
ReadResource에 넘겨, 원격 객체의 지금 모습을 다시 읽어 온다. 그 결과가 이전 상태(Prior State)다. 상태 파일이 테라폼이 마지막으로 알고 있던 인프라의 모습이라면, 이전 상태는 지금 실제로 존재하는 인프라의 모습이다. - 설정 평가:
resource블록 본문을 프로바이더 스키마에 맞춰 값으로 평가한다. 아직 만들어지지 않은 다른 리소스의 속성을 참조하는 값은 이 시점에 알 수 없으므로 unknown으로 표시된다.terraform plan출력에 보이는(known after apply)가 바로 이 값이다. - 제안된 새 상태 만들기:
objchange.ProposedNew가 설정과 이전 상태를 병합해 제안된 새 상태(Proposed New State)를 만든다. 사용자가 설정에 적은 속성은 설정 값을 따르고, 프로바이더가 정하는 계산된 속성computed attribute13은 이전 상태의 값을 유지한다. - 프로바이더에게 계획 묻기: 제안된 새 상태를
PlanResourceChangeRPC로 프로바이더에게 보낸다. 프로바이더는 자신만 아는 리소스 규칙을 적용해 계획된 상태(Planned State)와, 바뀌면 객체를 교체해야 하는 속성 목록(RequiresReplace)을 돌려준다. 예컨대 EC2 인스턴스의 AMI는 실행 중에 바꿀 수 없으므로ami가 바뀌면 교체가 필요하다고 답하는 식이다. 코어는 이 응답을 그대로 믿지 않고 스키마 타입에 맞는지, 사용자가 명시한 값을 프로바이더가 멋대로 바꾸지 않았는지를objchange.AssertPlanValid로 검증한다. - 변경 종류 결정: 마지막으로
getAction이 이전 상태와 계획된 상태를 비교해 이 인스턴스에 가할 변경의 종류를 정한다.
이 과정을 의사코드로 옮기면 다음과 같다. 실제 구현의 쓰기 전용 속성 처리나 지연deferral 처리는 생략했다.
\begin{algorithm}
\caption{리소스 인스턴스 하나에 대한 계획}
\begin{algorithmic}
\Require 지난 실행의 상태 $s_{\text{prev}}$, 리소스 설정 $c$, 교체 강제 여부 $f$, 교체 시 먼저 만들지 여부 $b$
\Ensure 변경 종류 $a$와 계획된 상태 $s_{\text{plan}}$
\Function{PlanInstance}{$s_{\text{prev}}, c, f, b$}
  \State $s_{\text{prior}} \gets$ \Call{ReadResource}{$s_{\text{prev}}$} \Comment{새로고침}
  \State $v \gets$ \Call{EvaluateBlock}{$c$} \Comment{스키마에 맞춰 설정 평가}
  \State $s_{\text{prop}} \gets$ \Call{ProposedNew}{$s_{\text{prior}}, v$}
  \State $(s_{\text{plan}}, R) \gets$ \Call{PlanResourceChange}{$v, s_{\text{prior}}, s_{\text{prop}}$} \Comment{프로바이더 RPC}
  \State $a \gets$ \Call{GetAction}{$s_{\text{prior}}, s_{\text{plan}}, f, R, b$}
  \Return $(a, s_{\text{plan}})$
\EndFunction
\Function{GetAction}{$s_{\text{prior}}, s_{\text{plan}}, f, R, b$}
  \If{$s_{\text{prior}} = \text{null}$}
    \State $a \gets \text{Create}$ \Comment{아직 존재하지 않는 객체}
  \ElsIf{$f \lor R \neq \emptyset$}
    \If{$b$}
      \State $a \gets \text{CreateThenDelete}$
    \Else
      \State $a \gets \text{DeleteThenCreate}$
    \EndIf
  \ElsIf{$s_{\text{plan}} = s_{\text{prior}}$}
    \State $a \gets \text{NoOp}$ \Comment{이미 원하는 상태}
  \Else
    \State $a \gets \text{Update}$
  \EndIf
  \Return $a$
\EndFunction
\end{algorithmic}
\end{algorithm}
create_before_destroy 수명 주기 옵션14에 따라 교체는 새로 만든 뒤 지우거나 지운 뒤 새로 만드는 과정 중 하나가 된다. 교체가 결정되면 테라폼은 이전 상태를 비운 채로 PlanResourceChange를 한 번 더 호출한다. 그래야 새 객체의 계산된 속성이 옛 객체의 값이 아니라 unknown으로 표시된 계획을 얻을 수 있기 때문이다. 한편 삭제(Delete)는 GetAction에서 나오지 않는다. 삭제는 설정에서 사라진 리소스를 다루는 별도의 정점, 즉 앞서 본 OrphanResourceInstanceTransformer가 만든 정점에서 결정된다.
이렇게 모든 정점의 순회가 끝나면 인스턴스별 변경이 모여 하나의 계획plan이 된다. terraform plan -out=tfplan으로 저장하면 이 계획이 파일로 남고, 나중에 terraform apply tfplan이 그 파일을 그대로 실행한다.
5단계: 적용
terraform apply는 계획 단계와 같은 엔진을 쓰지만 그래프의 재료가 다르다. 적용 단계의 ApplyGraphBuilder는 설정에서 그래프를 다시 유도하지 않고, DiffTransformer로 계획에 담긴 변경에서 정점을 만든다. NoOp으로 기록된 인스턴스는 사용자가 정의한 조건 검사가 있을 때 그것만 수행하고 지나가며, 실제 작업은 생성·수정·교체가 기록된 인스턴스에서만 일어난다. 각 리소스 정점(NodeApplyableResourceInstance.managedResourceExecute)에서 벌어지는 일은 다음과 같다.
- 계획 다시 세우기: 의존하던 리소스가 방금 만들어졌으므로, 계획 시점에 unknown이던 값(예: 서브넷 ID)이 이제는 확정되어 있다. 테라폼은 확정된 설정으로 계획을 한 번 더 세우고(Final Planned State), 그것이 사용자가 승인한 계획과 모순되지 않는지 확인한다. 모순되면 적용을 중단한다.
- 프로바이더에게 적용 요청: 프로바이더의
ApplyResourceChangeRPC를 호출한다. 실제 프로비저닝은 바로 이 호출 너머에서 일어난다. AWS 프로바이더는 요청을 받아 EC2 인스턴스 생성이라면RunInstances같은 AWS API를 호출하고, 그 결과로 생긴 객체의 모습(New State)을 돌려준다. - 상태 기록: 돌려받은 새 상태를 그 자리에서 상태에 기록한다. 호출이 실패하면 반쯤 만들어진 객체를 오염됨tainted15으로 표시해 기록한다.
3번이 리소스 단위로 일어난다는 점이 중요하다. 리소스 100개를 적용하다 중간에 하나가 실패하더라도, 이미 성공한 리소스는 상태에 남아 있다. 다음 실행은 이 상태를 출발점으로 삼아 남은 일만 다시 계획하므로, 사용자는 문제를 고친 뒤 같은 명령을 다시 실행하기만 하면 된다.
덧붙여 terraform destroy는 별도의 엔진이 아니다. commands.go는 destroy를 ApplyCommand{Destroy: true}로 등록한다. 삭제란 "모든 리소스가 사라진 상태"를 원하는 상태로 삼는 적용일 뿐이다.
멱등성과 드리프트
이제 앞에서 선언적 방식의 장점으로 꼽은 멱등성이 어디서 오는지를 구현 수준에서 설명할 수 있다. 같은 설정으로 apply를 두 번 실행한다고 해 보자. 두 번째 실행의 새로고침은 첫 번째 실행이 만든 객체를 읽어 오고, 설정이 바뀌지 않았으므로 프로바이더가 돌려준 계획된 상태는 이전 상태와 같다. 그러면 모든 인스턴스가 GetAction의 NoOp 분기로 들어가고, 테라폼은 "No changes"를 보고한 채 어떤 API도 호출하지 않는다. 즉 테라폼의 멱등성은 사용자가 코드로 보장하는 성질이 아니라, "새로고침 → 비교 → NoOp" 경로가 구조적으로 보장하는 성질이다.16 절차적 방식에서는 이 비교를 누가 맡는지가 달라지는데, 이는 앤서블 절에서 다시 살펴본다.
드리프트configuration drift도 같은 경로를 통해 드러난다. 드리프트란 시간이 지나며 실제 인프라 상태가 코드에 정의된 상태와 달라지는 현상이다. 누군가 콘솔에서 보안 그룹 규칙을 직접 추가하거나, 오토스케일링이 이루어지는 과정에서 오토스케일링 그룹의 희망 용량을 바꾸는 경우가 그렇다. 새로고침으로 얻은 이전 상태가 상태 파일의 기록과 다르면, Context.Plan은 그 차이를 계획과 별도로 모아(driftedResources) "Objects have changed outside of Terraform"이라는 메시지와 함께 보여 준다. 그리고 설정은 그대로이므로 GetAction은 실제 상태를 설정대로 되돌리는 Update를 계획한다. 다시 말해 테라폼의 드리프트 감지는 별도의 기능이라기보다 매 계획마다 수행되는 새로고침의 부산물이다.
이 새로고침만 따로 떼어 쓰는 방법도 있다. terraform plan -refresh-only는 리프레시 전용 모드(plans.RefreshOnlyMode)로 계획을 세운다. 소스 코드의 주석에 따르면 이 모드는 이전 상태를 원격 객체와 동기화하는 일만 수행하고, 설정이 상태와 달라졌더라도 리소스 인스턴스에 대한 변경은 만들지 않는다(internal/plans/mode.go). 그래서 계획에는 밖에서 바뀐 것만 남는다. 그 변경이 의도된 것이었다면 terraform apply -refresh-only로 상태에만 반영하고 설정을 그에 맞게 고치면 되고, 의도되지 않은 것이었다면 평소처럼 terraform apply로 설정대로 되돌리면 된다. 드리프트를 "감지"하는 일과 "되돌리는" 일을 분리해 사람이 그 사이에서 판단할 수 있게 하는 셈이다.
드리프트는 예측 불가능성의 원천이다. 코드를 보고 인프라 상태를 파악할 수 없게 되고, 다음 apply 때 예상치 못한 변경이 발생할 수 있다. 그래서 IaC의 핵심 원칙 중 하나는 코드가 인프라의 유일한 진실의 원천single source of truth이어야 한다는 것이다. 『데브옵스 핸드북』도 운영 환경을 수동으로 바꾸지 못하게 하고 모든 변경을 버전 관리를 거쳐서만 반영하는 것을, 인프라가 알려진 좋은 상태에서 표류drift하는 경로를 체계적으로 줄이는 방법으로 제시한다(Kim et al., 2021). 콘솔에서의 직접 수정은 드리프트를 만들기 때문에 IaC 환경에서는 지양해야 하며, terraform plan -refresh-only나 terraform plan을 주기적으로 실행하거나 CI 파이프라인에 포함시키면 드리프트를 조기에 감지할 수 있다. 나아가 인프라의 변경이 반드시 Git 커밋과 코드 리뷰를 거쳐서만 반영되도록 흐름 자체를 강제하는 운영 방식이 GitOps다.
선언부터 API 호출까지
지금까지의 과정을 한 장으로 모으면 다음과 같다.
그림 8. 테라폼에서 코드를 통해 인프라를 선언한 시점부터 실제 프로비저닝까지의 경로를 나타낸 그림.
선언적 방식이 실제 프로비저닝과 연결되는 지점은 세 군데로 요약된다. 첫째, 리소스 사이의 참조가 그래프의 간선이 되어 실행 순서를 결정한다. 둘째, 매 실행마다 새로고침한 실제 상태와 설정을 비교해 생성·수정·교체·무변경 중 하나를 고르므로, 사용자가 절차를 적지 않아도 필요한 변경만 일어난다. 셋째, 그 변경을 프로바이더라는 별도 프로그램이 실제 API 호출로 번역하므로, 코어의 이 모든 논리는 클라우드의 종류와 무관하게 동작한다.
절차적 방식 - Ansible
그림 9. 앤서블이 인프라를 구성하는 기본적인 실행 흐름. 컨트롤 노드가 SSH로 관리 노드에 접속해 모듈을 보내고, 모듈은 관리 노드 안에서 실행된 뒤 결과를 JSON으로 돌려준다.
앤서블(Ansible)은 레드햇(Red Hat)이 후원하는 오픈소스 자동화 도구로, 수행할 절차를 YAML(YAML Ain't Markup Language)로 된 플레이북(playbook)에 순서대로 적고 그 절차를 SSH(Secure Shell, 보안 셸)로 접속한 호스트에서 차례로 실행한다. 대상 호스트에 에이전트를 설치할 필요가 없는 에이전트리스(agentless) 방식이고, 리눅스나 유닉스 호스트라면 파이썬 인터프리터만 있으면 되기 때문에 서버 구성 관리configuration management뿐만 아니라 클라우드 자원을 만드는 프로비저닝에도 두루 쓰인다.17 플레이북에 적힌 절차가 대상 호스트에서 어떻게 실행되어 실제 변경으로 이어지는지, 그리고 절차적 방식에서 멱등성이 어떻게 보장되는지를 앤서블 소스 코드18를 따라가보며 알아보자.
기본 구조
앤서블로 인프라를 다루기 위해서는 인벤토리(inventory)와 플레이북, 두 가지를 작성해야 한다. 인벤토리는 다룰 호스트와 그룹의 목록이고, 플레이북은 그 호스트들에서 수행할 절차다. 플레이북은 플레이(play)의 목록이고, 플레이는 어떤 호스트 집합에서 어떤 태스크(task)들을 수행할지를 정하며, 태스크 하나는 모듈(module) 하나를 인수와 함께 호출하는 것이다. 웹 서버 두 대에 Nginx를 설치하는 예시를 보자.
[web]
web1.example.com
web2.example.com
- name: 웹 서버 구성
hosts: web
become: true
tasks:
- name: Nginx 설치
ansible.builtin.apt:
name: nginx
state: present
- name: 설정 파일 배포
ansible.builtin.template:
src: nginx.conf.j2
dest: /etc/nginx/nginx.conf
notify: Nginx 재시작
- name: Nginx 실행
ansible.builtin.service:
name: nginx
state: started
enabled: true
handlers:
- name: Nginx 재시작
ansible.builtin.service:
name: nginx
state: restartedhosts는 이 플레이가 적용될 호스트를 인벤토리에서 고르는 패턴(여기서는 그룹 web)이고, become은 관리자 권한으로 작업하라는 뜻이다. tasks 아래의 각 항목이 태스크이며, ansible.builtin.apt처럼 모듈 이름을 키로, 그 아래 인수를 값으로 적는다. 세 태스크는 적힌 순서대로 실행된다. 패키지를 설치하고, 설정 파일을 배포하고, 서비스를 시작한다. 테라폼 설정에서는 리소스 사이의 참조가 순서를 결정했지만, 플레이북에서는 작성자가 적은 순서가 곧 실행 순서다. notify와 handlers는 절차적 방식에서 필요할 때만 무언가를 하기 위한 장치다. 설정 파일이 실제로 바뀌었을 때만 핸들러handler가 통지되고, 통지된 핸들러는 tasks가 모두 끝난 뒤에 한 번 실행되어 Nginx를 재시작한다.
주목할 점은 각 태스크의 인수가 state: present나 state: started처럼 원하는 상태를 적는다는 것이다. 즉 앤서블의 절차는 apt-get install같은 명령어가 아니라 nginx 패키지가 설치된 상태와 같은 상태의 나열이다. 다만 이 "원하는 상태"의 범위는 태스크 하나, 그러니까 인프라의 자원 하나에 국한된다. 테라폼이 설정 전체와 실제 인프라 전체를 비교하는 것과 달리 앤서블에서 비교의 단위는 모듈 호출 한 번이다. 이 차이가 이 절 전체를 관통하는 주제다.
상태 파일 대신 팩트
앤서블에는 테라폼의 상태 파일에 해당하는 것이 없다. 지난 실행이 무엇을 만들었는지 기록해 두는 장부가 없으므로 앤서블에서 모든 실행은 대상 호스트의 현재 모습을 직접 조사하는 데서 출발한다. 그 조사는 두 개의 층위에서 일어난다. 첫째, 플레이가 시작될 때 암묵적인 gather_facts 태스크가(기본 설정에서는 setup 모듈을 실행해) 호스트의 운영체제, 네트워크 인터페이스, 메모리, 배포판 같은 정보를 모아 팩트facts라는 변수 집합(ansible_facts)으로 돌려준다. 둘째, 각 태스크의 모듈이 자기 자원의 현재 상태를 읽어 요청된 상태와 비교한다.
실행 중에 얻은 결과는 register로 변수에 담아 뒤따르는 태스크의 조건(when)에 쓸 수 있고, 팩트는 같은 실행 안에서 다음 플레이까지 유지된다. 그러나 실행이 끝나면 (팩트 캐시를 따로 켜지 않는 한19) 아무것도 남지 않는다. 그래서 플레이북에서 태스크를 지운다고 해서 그 태스크가 만들었던 자원이 사라지지는 않는다. 테라폼이 설정에서 사라진 리소스를 상태 파일과 비교해 삭제 대상으로 찾아내는 것과 달리, 앤서블에서 무언가를 없애려면 state: absent라는 절차를 새로 적어야 한다.
그림 10. 앤서블에서 상태가 다뤄지는 방식. 상태 파일이 없는 대신, 매 실행마다 팩트와 각 모듈의 조사 결과가 "현재 상태"의 역할을 한다.
핵심 워크플로우
ansible-inventory -i inventory.ini --graph          # 인벤토리 확인
ansible web -i inventory.ini -m ping                # 애드혹 명령: 모듈 하나만 실행
ansible-playbook -i inventory.ini site.yml --check --diff  # 드라이 런 (실제 변경 없음)
ansible-playbook -i inventory.ini site.yml          # 실행
인벤토리를 확인할 때는 ansible-inventory를 쓴다. ansible 명령은 플레이북 없이 모듈 하나를 여러 호스트에서 바로 실행하는 애드혹ad hoc 명령으로, 내부적으로는 태스크 하나짜리 플레이를 즉석에서 만들어 같은 엔진에 넘긴다. 실제 변경 없이 무엇이 바뀔지 미리 보려면 ansible-playbook --check를 쓰고, --diff를 붙이면 파일 내용의 차이도 보여 준다. 다만 테라폼의 plan과 달리 --check는 변경 계획을 계산하는 별도의 단계가 아니라, 각 모듈에게 "실제로 바꾸지는 말고 바꿀지 여부만 보고하라"고 부탁하는 실행 모드다. 그래서 체크 모드를 지원하지 않는 모듈은 그 태스크를 건너뛴다. 실행이 끝나면 호스트마다 ok, changed, unreachable, failed, skipped, rescued, ignored 횟수를 집계한 요약play recap이 출력된다.
이 명령들은 모두 컨트롤 노드에서 대상 호스트로 밀어내는(push) 방향으로 동작한다. 반대로 각 호스트가 Git 같은 버전 관리 저장소에서 플레이북을 받아 스스로 실행하는 ansible-pull도 있는데, 이는 저장소를 받아온 뒤 로컬에서 ansible-playbook을 실행하는 것일 뿐이므로 푸시 방식을 기준으로 핵심 워크플로우를 자세히 알아보자.
절차가 실행되기까지
사용자 입장에서 ansible-playbook site.yml은 명령 한 줄이지만, 그 안에서 플레이북에 적힌 절차는 어떤 호스트에서 어떤 모듈을 어떤 순서로 실행할 것인지를 결정하는 스크립트로 바뀌어 실제 호스트의 변경으로 이어진다. 테라폼의 핵심이 선언을 절차로 바꾸는 번역기였다면, 앤서블의 핵심은 적힌 절차를 그대로 지키면서 여러 호스트에서 실행하는 스케줄러와, 절차의 각 단계를 원격 호스트에서 실행하는 전송 장치다. 핵심 워크플로우를 더욱 자세히 파고들며 플레이북 한 장이 호스트의 변경이 되기까지의 과정을 단계별로 살펴보자.
그림 11. 플레이북 하나를 실행하는 동안 컨트롤 노드와 관리 노드에서 벌어지는 일. 위쪽 상자 안의 화살표는 컨트롤 노드에서 일어나는 호출 순서다. WorkerProcess부터는 ansible-playbook 프로세스가 호스트·태스크마다 fork한 자식 프로세스 안에서 실행되고, ssh 연결 플러그인은 그 안에서 다시 OpenSSH를 자식 프로세스로 띄운다. 관리 노드에는 상주하는 코드가 없고, 모듈 하나가 실행되는 동안만 스크립트가 존재한다.
컨트롤 노드와 관리 노드의 분리
앤서블 저장소의 README.md에서는 별도의 에이전트나 추가 포트 없이, 이미 있는 SSH 데몬을 활용해 에이전트리스로 동작하는 것을 앤서블의 설계 원칙으로 꼽는다. 테라폼에서 실제 API를 호출하는 코드가 프로바이더라는 별도 실행 파일에 있었듯이, 앤서블에서 실제로 호스트를 바꾸는 코드는 컨트롤 노드가 아니라 관리 노드에서 실행되는 모듈에 있다. 다만 프로바이더가 컨트롤 노드 옆에서 계속 떠 있는 자식 프로세스였다면, 모듈은 태스크 하나를 실행할 때마다 관리 노드로 보내졌다가 사라지는 프로그램이다.
이 전송 형식이 AnsiballZ20다. 컨트롤 노드의 액션 플러그인action plugin은 모듈 파일과 그 모듈이 임포트하는 module_utils를 하나의 zip으로 묶어 base64로 인코딩하고, 모듈 인수를 JSON으로 직렬화한 뒤, 이 둘을 인수로 하는 _ansiballz_main(...) 호출을 래퍼 스크립트 뒤에 덧붙인다.
        params = dict(ANSIBLE_MODULE_ARGS=module_args,)
        encoder = get_module_encoder(cached_module.metadata.serialization_profile, Direction.CONTROLLER_TO_MODULE)
        # ...
        code = _get_ansiballz_code(shebang)
        args = dict(
            ansible_module=module_name,
            module_fqn=remote_module_fqn,
            profile=cached_module.metadata.serialization_profile,
            # ...
            params=encoded_params,
            # ...
            zip_data=to_text(cached_module.zip_data),
        )

        args_string = '\n'.join(f'{key}={value!r},' for key, value in args.items())

        wrapper = f"""{code}


if __name__ == "__main__":
    _ansiballz_main(
{args_string}
)
"""
그 결과물은 파이썬 스크립트 하나다. 관리 노드에 앤서블이 설치되어 있을 필요가 없는 이유는, 이 스크립트가 임시 디렉터리에 zip 파일을 그대로 써 두고 그 zip 경로를 sys.path 맨 앞에 넣은 뒤(파이썬은 zip 안에서 직접 임포트할 수 있다), zip 안에 함께 실려 온 _loader가 모듈을 __main__으로 실행하기 때문이다(lib/ansible/_internal/_ansiballz/_wrapper.py, lib/ansible/module_utils/_internal/_ansiballz/_loader.py). 파이썬 인터프리터의 위치도 미리 알 필요가 없다. ansible_python_interpreter를 따로 주지 않으면(기본값 auto) 그 호스트에서 파이썬 모듈을 처음 만들 때 command -v python3.14 같은 셸 명령을 후보 버전마다 차례로 실행해 첫 번째로 찾은 것을 쓰고, 그 경로를 discovered_interpreter_python 팩트로 기억해 둔다(lib/ansible/executor/interpreter_discovery.py).
이 분리가 절차와 실제 변경을 잇는 첫 번째 열쇠다. 컨트롤 노드는 어느 호스트에서 어떤 모듈을 어떤 인수로 실행할지만 정하고, 그 모듈이 호스트를 어떻게 바꾸는가는 모듈에게 맡긴다. 덕분에 엔진은 패키지 관리자나 서비스 관리자를 전혀 몰라도 되고, 새로운 종류의 자원을 다루려면 인수를 JSON으로 받고 결과를 JSON으로 출력하는 모듈을 하나 더 만들기만 하면 된다. 앤서블이 수천 개의 모듈을 거느릴 수 있는 이유가 여기에 있다.
1단계: 플레이북 해석
가장 먼저 앤서블은 플레이북 YAML을 읽어 플레이 → 블록(block) → 태스크의 객체 트리로 만든다. Playbook.load(lib/ansible/playbook/__init__.py)는 문서가 리스트인지 확인한 뒤 항목을 순서대로 Play 객체로 만들고, import_playbook 항목은 그 자리에서 펼쳐 끼워 넣는다. 플레이의 pre_tasks, tasks, post_tasks, handlers는 load_list_of_blocks(lib/ansible/playbook/helpers.py)를 거쳐 블록의 리스트가 되는데, block: 없이 연속해서 나열된 태스크들도 암묵적인 블록 하나로 묶인다. 태스크 하나는 ModuleArgsParser(lib/ansible/parsing/mod_args.py)가 ansible.builtin.apt: {...} 같은 키를 action과 args로 분리해 만든다.
이 단계에서 눈여겨볼 것은 두 가지다. 첫째, 테라폼의 설정 해석이 참조 관계를 모으는 과정이었다면, 앤서블의 해석은 YAML 리스트를 파이썬 리스트로 옮기는 과정이다. 순서는 리스트의 위치 그 자체이고, 그 밖에 순서를 정하는 정보는 어디에도 없다. 둘째, 값은 아직 템플릿 그대로다. {{ nginx_port }} 같은 Jinja221 표현식은 이 단계에서 평가되지 않고 나중에 호스트마다 태스크가 실행되기 직전에 그 호스트의 변수로 평가된다.
플레이가 실행될 차례가 오면 Play.compile(lib/ansible/playbook/play.py)이 리스트를 이어붙여 최종 실행 순서를 만든다.
        block_list.extend(self.pre_tasks)
        block_list.append(flush_block)
        block_list.extend(self._compile_roles())
        block_list.extend(self.tasks)
        block_list.append(flush_block)
        block_list.extend(self.post_tasks)
        block_list.append(flush_block)

return block_listflush_block은 그때까지 통지된 핸들러를 실행하는 meta: flush_handlers 태스크 하나를 담은 블록이다. pre_tasks, 역할role22의 태스크(의존하는 역할이 먼저), tasks, post_tasks가 한 줄로 이어지고 그 사이사이에 핸들러 실행 지점이 끼어든다. import_tasks와 import_role은 이 해석 단계에 파일을 읽어 그 자리에 끼워 넣지만(정적), include_tasks와 include_role은 태스크 객체로 남아 있다가 실행 중에 호스트마다 펼쳐진다(동적). 그래서 include_*는 팩트나 반복 변수에 따라 다른 파일을 고를 수 있지만, --list-tasks에는 include_tasks 태스크 한 줄만 나타나고 그 파일 안의 태스크들은 나타나지 않는다.
2단계: 호스트별 커서
컴파일된 블록 리스트를 실제로 걷는 것은 PlayIterator(lib/ansible/executor/play_iterator.py)다. 테라폼이 리소스마다 그래프의 정점을 두었다면, 앤서블은 호스트마다 HostState라는 상태 기계state machine23를 둔다. HostState는 블록 리스트의 복사본, 몇 개의 정수 커서(cur_block, cur_regular_task, cur_rescue_task, cur_always_task), 지금 어느 구역을 걷고 있는지를 나타내는 run_state, 그리고 어느 구역에서 실패했는지를 기록하는 fail_state 비트로 이루어진다. 프로그램 카운터와 다름없다.
그림 12. 호스트 하나의 HostState가 거치는 상태. 실패는 예외가 아니라 커서가 rescue 구역으로 건너뛰는 상태 전이로 처리된다.
PlayIterator는 만들어질 때 Play.compile의 결과 맨 앞에 팩트를 수집하는 암묵적인 gather_facts 태스크를 끼워 넣고, --tags로 걸러낸 뒤, 호스트마다 HostState를 만든다. 후술할 전략 플러그인이 "이 호스트의 다음 태스크는 무엇인가"를 물으면(get_next_task_for_host) 이터레이터는 상태의 복사본 위에서 커서를 전진시켜 태스크를 돌려주고, peek=True로 물었다면 그 복사본을 이터레이터에 기록하지 않고 호출자에게 돌려주기만 한다. 호출자가 나중에 set_state_for_host로 그 복사본을 넘겨야 비로소 확정된다. 이 엿보기와 확정의 분리가 다음 단계의 재료가 된다.
실패 처리의 핵심도 이 상태 기계 안에 있다. 전략이 mark_host_failed를 부르면 _set_failed_state가 현재 구역의 실패 비트를 켜고 run_state를 rescue 구역으로, 없으면 always 구역으로, 그것도 없으면 COMPLETE로 옮긴다.
        elif state.run_state == IteratingStates.TASKS:
            if state.tasks_child_state is not None:
                state.tasks_child_state = self._set_failed_state(state.tasks_child_state)
            else:
                state.fail_state |= FailedStates.TASKS
                if state._blocks[state.cur_block].rescue:
                    state.run_state = IteratingStates.RESCUE
                elif state._blocks[state.cur_block].always:
                    state.run_state = IteratingStates.ALWAYS
                else:
                    state.run_state = IteratingStates.COMPLETE
rescue 구역을 끝까지 무사히 걸으면 실패 비트가 지워지고, 그 호스트는 플레이 요약에서 failed가 아니라 rescued로 집계된다. 즉 block/rescue/always는 대표적인 예외처리 문법인 try/except/finally를 커서 위에 구현한 것이다. 테라폼처럼 실패한 정점에 의존하는 정점을 건너뛰는 일은 없다. 그런 의존 관계 자체가 없기 때문이다. 대신 실패한 호스트는 더 이상 다음 태스크를 받지 않을 뿐이고, 다른 호스트는 영향을 받지 않는다. 롤백도 없다. 이미 실행된 태스크의 결과는 호스트에 그대로 남고, 되돌리는 절차가 필요하다면 사용자가 rescue에 직접 적어야 한다.
3단계: 전략의 lock-step 스케줄링
호스트별 상태 기계를 누가 어떤 순서로 전진시킬지는 전략strategy 플러그인이 정한다. 기본 전략인 linear(lib/ansible/plugins/strategy/linear.py)는 모든 호스트가 태스크 N을 끝낸 뒤에야 누구든 태스크 N+1을 시작하는 lock-step 방식이다. 이를 위해 이터레이터는 플레이의 모든 태스크를 한 줄로 펼친 all_tasks와 그 위의 전역 커서 cur_task를 따로 둔다.
        state_task_per_host = {}
        for host in hosts:
            state, task = iterator.get_next_task_for_host(host, peek=True)
            if task is not None:
                state_task_per_host[host] = state, task
        # ...
        task_uuids = {t._uuid for s, t in state_task_per_host.values()}
        # ...
                cur_task = iterator.all_tasks[iterator.cur_task]
        # ...
                iterator.cur_task += 1
                if cur_task._uuid in task_uuids:
                    break
        # ...
        host_tasks = []
        for host, (state, task) in state_task_per_host.items():
            if cur_task._uuid == task._uuid:
                iterator.set_state_for_host(host.name, state)
host_tasks.append((host, task))_get_next_task_lockstep은 매 라운드마다 모든 호스트의 다음 태스크를 엿본 뒤, 전역 커서를 어느 호스트든 원하는 태스크에 닿을 때까지 전진시키고 바로 그 태스크를 다음 태스크로 가진 호스트들만 상태를 확정해 돌려준다. rescue 구역에 가 있는 호스트처럼 다음 태스크가 다른 호스트는 이번 라운드에서 빠지고 전역 커서가 자기 태스크에 닿을 때까지 기다린다. 함수의 독스트링은 아직도 빈 "noop 태스크"를 끼워 넣어 줄을 맞춘다고 적혀 있지만, 지금 구현은 빠뜨리는 방식으로 줄을 맞추며 단위 테스트(test/units/plugins/strategy/test_linear.py)가 그 동작을 고정하고 있다.
라운드마다 전략은 선택된 호스트 각각에 대해 변수를 모으고(VariableManager.get_vars), meta 태스크면 컨트롤 노드 안에서 직접 처리하고, 아니면 워커 프로세스 한 개를 복제fork해서 태스크를 맡긴다. 워커는 호스트·태스크 쌍마다 새로 만들어지는 자식 프로세스이고, 동시에 살아 있을 수 있는 워커의 수가 forks(기본값 5)다. 그리고 이번 라운드의 결과가 결과 큐를 통해 모두 돌아올 때까지 기다린 뒤에야(_wait_on_pending_results) 다음 라운드로 넘어간다. 병렬성은 호스트 사이에만 있고 태스크 사이에는 없다. 결과가 모이면 any_errors_fatal(플레이·블록·태스크 어디에나 둘 수 있고, 전략은 태스크마다 평가한다)이나 플레이 수준의 max_fail_percentage 같은 정책이 적용된다. 전자는 한 호스트라도 실패하거나 도달 불가가 되면(ignore_errors가 붙은 결과는 제외) 나머지 호스트도 실패로 표시하고, 후자는 실패한 호스트의 비율이 임계치를 넘으면 플레이를 중단한다. 둘 다 "모든 호스트가 같은 태스크를 막 끝낸 순간"이 있어야 가능한 정책이라, 호스트마다 독립적으로 진행하는 free 전략에서는 쓸 수 없다. 한편 serial을 주면 PlaybookExecutor가 호스트를 묶음으로 나누어 플레이 전체를 묶음마다 반복하므로 롤링 업데이트가 된다.
이 과정을 의사코드로 옮기면 다음과 같다. 실제 구현의 핸들러 처리와 include 펼치기, run_once 처리는 생략했다.
\begin{algorithm}
\caption{linear 전략이 플레이 하나를 실행하는 과정}
\begin{algorithmic}
\Require 플레이의 호스트 배치 $H$, 호스트별 상태 기계 $I$ (PlayIterator), 한 줄로 펼친 태스크 목록 $T$
\Ensure 플레이 결과 코드 $r$
\Function{RunPlay}{$H, I, T$}
  \State $r \gets \text{RUN\_OK}$, $c \gets 0$ \Comment{$c$는 $T$ 위의 전역 커서}
  \While{어느 호스트든 남은 태스크가 있음}
    \State $H' \gets$ \Call{HostsLeft}{$H$} \Comment{도달 불가 호스트 제외}
    \State $P \gets \{(h, \textsc{Peek}(I, h)) : h \in H'\}$ \Comment{호스트별 다음 태스크를 엿봄 (확정하지 않음)}
    \State $T[c]$가 $P$의 어떤 호스트가 원하는 태스크가 될 때까지 $c$를 전진
    \State $S \gets \{h : (h, t) \in P,\ t = T[c]\}$ \Comment{이번 라운드에 참여하는 호스트}
    \ForAll{$h \in S$}
      \State \Call{Commit}{$I, h$} \Comment{엿본 상태를 확정}
      \State $v \gets$ \Call{GetVars}{$h, T[c]$} \Comment{변수 우선순위대로 병합}
      \If{$T[c]$가 meta 태스크}
        \State \Call{ExecuteMeta}{$h, T[c]$} \Comment{flush\_handlers, end\_play 등}
      \Else
        \State \Call{QueueTask}{$h, T[c], v$} \Comment{워커 프로세스 fork}
      \EndIf
    \EndFor
    \State $R \gets$ \Call{WaitOnPendingResults}{} \Comment{결과가 모두 모일 때까지 대기 (장벽)}
    \If{any\_errors\_fatal $\land$ $R$에 실패 또는 도달 불가가 있음}
      \State 남은 호스트를 모두 실패로 표시
    \EndIf
    \If{실패한 호스트의 비율 $>$ max\_fail\_percentage}
      \State $r \gets r \lor \text{RUN\_FAILED\_BREAK\_PLAY}$
    \EndIf
    \If{$r \neq \text{RUN\_OK} \land$ 남은 호스트가 모두 실패}
      \Return $r$
    \EndIf
  \EndWhile
  \Return \Call{ResultCode}{$I$} \Comment{도달 불가 호스트가 있으면 4, 실패가 있으면 2, 아니면 0}
\EndFunction
\end{algorithmic}
\end{algorithm}
4단계: 모듈 전송
워커 프로세스 안에서는 TaskExecutor(lib/ansible/executor/task_executor.py)가 태스크 하나를 끝까지 책임진다. 먼저 loop가 있으면 항목을 계산하고, 항목마다 when 조건을 그 호스트의 변수로 평가한다. 조건이 거짓이면 연결을 맺기도 전에 skipped 결과를 만든다. 그다음 태스크의 키워드들을 템플릿으로 평가하고(post_validate), 연결 플러그인(ansible_connection, 기본값 ssh)과 액션 플러그인을 고른다. copy나 template처럼 모듈과 같은 이름의 액션 플러그인이 있으면 그것을, 없으면 범용 normal 액션을 쓴다. 대부분의 모듈은 normal을 쓰는데, 이 플러그인이 하는 일은 _execute_module을 호출하고 끝나면 원격 임시 디렉터리를 지우는 것이 전부다.
_execute_module(lib/ansible/plugins/action/__init__.py)은 (파이프라이닝이 꺼져 있으면 원격 임시 디렉터리를 먼저 만든 뒤) 모듈 인수에 컨트롤 노드가 정한 제어 값을 끼워 넣는 데서 시작한다. 체크 모드가 그중 하나다.
    def _update_module_args(self, module_name, module_args, task_vars, ignore_unknown_opts: bool = False):

        # set check mode in the module arguments, if required
        if self._task.check_mode:
            if not self._supports_check_mode:
                raise AnsibleError("check mode is not supported for this operation")
            module_args['_ansible_check_mode'] = True
        else:
            module_args['_ansible_check_mode'] = False
        # ...
        # let module know we are in diff mode
module_args['_ansible_diff'] = self._task.diff--check는 계획을 세우는 별도의 단계가 아니라, 모듈 인수 안에 실려 가는 불리언 하나다. 그다음 앞서 본 AnsiballZ 포장이 만들어지고, 전송 방식이 결정된다. 파이프라이닝(pipelining)24이 켜져 있으면 스크립트를 파일로 올리지 않고 SSH 세션의 표준 입력으로 흘려보내므로 원격 명령은 셔뱅(shebang)25에서 가져온 인터프리터 경로 하나(예: /usr/bin/python3, 실제로는 /bin/sh -c '...'로 한 번 감싸인다)가 되고, 꺼져 있으면(기본값) 먼저 원격 임시 디렉터리를 만들고 스크립트를 SFTP나 SCP26로 올린 뒤 실행하고 지운다. 권한 상승privilege escalation(become)이 필요하면 명령은 sudo -H -S -n -u root /bin/sh -c 'echo BECOME-SUCCESS-<무작위 문자열> ; <명령>' 꼴로 감싸이고, 컨트롤 노드는 출력 줄에 그 무작위 표식이 나타나는 것으로 권한 상승이 끝났음을 안다(명령 조립은 lib/ansible/plugins/become/sudo.py, 표식 생성과 검사는 lib/ansible/plugins/become/__init__.py의 check_success, 출력 줄 검사는 lib/ansible/plugins/connection/ssh.py의 _examine_output).
마지막으로 ssh 연결 플러그인(lib/ansible/plugins/connection/ssh.py)이 OpenSSH 클라이언트 바이너리를 자식 프로세스로 띄운다. 앤서블 코어는 자체 SSH 구현을 갖지 않으며, 연결 재사용도 OpenSSH의 ControlMaster27에 맡긴다. 원격 호스트에 필요한 것은 sshd, POSIX 셸28, 그리고 파이썬 인터프리터뿐이다. 이것이 "에이전트리스"의 실체다.
5단계: 모듈 실행과 결과
관리 노드에서 모듈은 AnsibleModule(lib/ansible/module_utils/basic.py)을 만들며 시작한다. 생성자는 래퍼가 전역 변수에 넣어 둔 JSON 인수를 읽고, _ansible_check_mode 같은 제어 키를 인수에서 떼어 내 self.check_mode 속성으로 옮긴 뒤, 모듈이 선언한 인수 명세(argument_spec)대로 타입 변환과 필수·선택지·상호 배타 검사를 수행한다. 검사에 실패하면 모듈 본문이 실행되기 전에 failed: true로 끝난다. 그리고 체크 모드가 요청되었는데 모듈이 supports_check_mode=True를 선언하지 않았다면, 본문을 실행하는 대신 skipped: true로 끝낸다.
        if self.check_mode and not self.supports_check_mode:
            self.exit_json(
                skipped=True,  # deprecated: description='remove this skipped return', core_version='2.25'
                msg="remote module (%s) does not support check mode" % self._name,
            )
모듈 본문이 할 일은 모듈마다 다르지만, 끝내는 방법은 하나다. exit_json(changed=..., ...) 또는 fail_json(msg=...)을 불러 결과 사전을 JSON 한 덩어리로 표준 출력에 찍고 프로세스를 종료한다. 이것이 모듈과 컨트롤 노드 사이의 규약 전부다. 테라폼의 프로바이더가 gRPC로 PlanResourceChange와 ApplyResourceChange를 주고받았다면, 앤서블의 모듈은 JSON 인수를 받아 JSON 결과를 출력하는 프로그램이면 된다. 그래서 모듈은 파이썬이 아니어도 된다. 중요한 것은 changed가 모듈이 스스로 보고하는 값이라는 점이다. basic.py는 changed의 기본값조차 정하지 않으며, 결과에 그 키가 없으면 컨트롤 노드가 거짓으로 간주할 뿐이다.
결과는 워커로 돌아와 UnifiedTaskResult라는 객체가 된다. 워커는 여기서 changed_when과 failed_when을 평가해 모듈의 판정을 덮어쓸 수 있고, until이나 retries가 있으면 같은 모듈을 다시 보내 재시도한다.
            if not utr.skipped:
                try:
                    if self._task.changed_when:
                        utr.set_changed_when_result(self._task._resolve_conditional(self._task.changed_when, task_ctx.task_vars))
                except AnsibleError as e:
                    utr.set_changed_when_result(e)
                else:
                    try:
                        if self._task.failed_when:
                            utr.set_failed_when_result(self._task._resolve_conditional(self._task.failed_when, task_ctx.task_vars))
                    except AnsibleError as e:
                        utr.set_failed_when_result(e)
워커는 결과를 큐에 넣고 종료한다. 컨트롤 노드의 전략은 결과를 꺼내 상태를 갱신한다. 실패면 이터레이터의 mark_host_failed를 부르고, 도달 불가면 호스트를 플레이에서 제외하며, 성공이면 팩트를 VariableManager에 기록하고 changed일 때만 notify된 핸들러 이름을 기억해 둔다. register 값은 성공·실패·건너뜀을 가리지 않고 모든 결과에 대해 기록되므로, 실패한 태스크의 결과도 뒤따르는 태스크에서 읽을 수 있다. 그리고 통계를 올리고 콜백 플러그인29을 통해 changed: [web1] 같은 한 줄을 출력한다. 다음 라운드의 when 조건과 템플릿은 방금 기록된 변수를 읽는다. 이것이 절차의 각 단계가 앞 단계의 결과에 따라 갈라질 수 있는 유일한 통로다.
멱등성은 어디에서 오는가
이제 절차적 방식에서 멱등성이 어디에서 오는지를 구현 수준에서 말할 수 있다. 엔진은 모듈을 보내고 changed를 읽어 올 뿐, 앞의 다섯 단계 어디에도 현재 상태와 원하는 상태를 비교하는 코드는 없었다. 비교는 모듈 안에서 일어난다. 파일을 다루는 모듈들이 공통으로 쓰는 set_mode_if_different가 그 전형이다.
        prev_mode = stat.S_IMODE(path_stat.st_mode)

        if prev_mode != mode:

            if diff is not None:
                if 'before' not in diff:
                    diff['before'] = {}
                diff['before']['mode'] = '0%03o' % prev_mode
                if 'after' not in diff:
                    diff['after'] = {}
                diff['after']['mode'] = '0%03o' % mode

            if self.check_mode:
                return True
            # ...
            path_stat = os.lstat(b_path)
            new_mode = stat.S_IMODE(path_stat.st_mode)

            if new_mode != prev_mode:
                changed = True
        return changed
현재 권한을 읽고 요청과 다를 때만 diff를 기록하고, 체크 모드면 바꾸지 않은 채 "바뀔 것"이라고 답하고, 아니면 chmod한 뒤 다시 읽어서 실제로 바뀐 경우에만 changed를 켠다. file 모듈이 심볼릭 링크를 다룰 때도 같은 모양이다. os.readlink로 지금 가리키는 곳을 읽어 요청한 src와 다를 때만 changed로 두고, changed and not module.check_mode일 때만 임시 링크를 만들어 os.rename으로 바꿔치기한다. copy와 template은 원본과 대상 파일의 SHA-1 체크섬을(이 둘은 예외적으로 컨트롤 노드의 액션 플러그인이 원격 stat 결과와 로컬 체크섬을 먼저 비교하고, 다를 때만 모듈을 보낸다), lineinfile은 파일을 통째로 읽은 줄 목록을, systemd_service는 systemctl show가 알려 주는 ActiveState를, dnf5는 설치된 패키지 질의 결과를 "현재 상태"로 삼는다. ==같은 플레이북을 두 번 실행했을 때 두 번째가 changed=0으로 끝나는 것은 엔진이 보장하는 성질이 아니라, 각 모듈이 "조사 → 비교 → 다를 때만 변경 → changed 보고"라는 규약을 지킨 결과다.== 테라폼의 멱등성이 "새로고침 → 비교 → NoOp" 경로가 구조적으로 보장하는 성질이었다면, 앤서블의 멱등성은 모듈 작성자의 규율이고 모듈의 판정이 마음에 들지 않을 때 사용자가 changed_when으로 덮어쓰는 것도 결국 비교를 사용자가 적는 일이다. command 모듈은 이 규약을 아예 지키지 않는다. 명령을 실행했다는 사실만으로 changed: true를 보고하며, 사용자가 creates(이 파일이 있으면 건너뛰라)나 removes(이 파일이 없으면 건너뛰라)라는 상태 표식을 직접 줄 때만 동일한 결과를 보장한다.
드리프트도 같은 관점에서 볼 수 있다. 테라폼은 상태 파일에 기록된 과거와 새로고침한 현재를 비교해 "밖에서 바뀐 것"을 따로 보여 주었다. 앤서블에는 과거의 기록이 없으므로 드리프트를 감지하는 기능도 없다. 대신 매 실행이 지금의 상태에서 출발해 플레이북에 적힌 상태로 되돌린다. 누군가 서버에서 설정 파일을 직접 고쳤다면 다음 template 태스크가 체크섬 차이를 보고 changed로 덮어쓰지만 그것이 드리프트였는지 원래 그랬는지는 구별하지 않는다. --check --diff로 실행하면 각 모듈이 바꿀 내용을 미리 보고하므로 이것이 사실상의 드리프트 점검이 된다. 다만 --check는 계획이 아니라 실행 모드이기 때문에 체크 모드를 지원하지 않는 모듈의 태스크나 creates/removes 없이 쓴 command처럼 결과를 예측할 수 없어 스스로 건너뛰는 태스크는 건너뛰어지고, 그 결과에 의존하는 뒤쪽 태스크의 판단은 실제 실행 때와 달라질 수 있다.
클라우드 자원을 만들 때
지금까지의 예시는 이미 있는 서버를 구성하는 일이었다. 그렇다면 테라폼처럼 EC2 인스턴스 자체를 만드는, 프로비저닝 도구로서의 앤서블은 어떻게 동작할까? AWS를 다루는 모듈은 ansible-core가 아니라 amazon.aws 컬렉션에 들어 있다.30 앞의 테라폼 예시와 같은 인스턴스를 만드는 플레이북은 다음과 같다.
- name: 웹 서버 인스턴스 프로비저닝
  hosts: localhost
  gather_facts: false
  tasks:
    - name: EC2 인스턴스 생성
      amazon.aws.ec2_instance:
        name: web-server
        region: ap-northeast-2
        image_id: ami-0c9c942bd7bf113a2
        instance_type: t3.micro
        exact_count: 1
        state: running
      register: web
겉보기에는 테라폼의 resource 블록과 거의 같지만, 그 아래에서 일어나는 일은 두 가지 점에서 앞의 Nginx 예시와 다르다.
첫째, 모듈이 실행되는 곳이 컨트롤 노드 자신이 된다. hosts: localhost인데 인벤토리에 localhost가 없으면 앤서블은 암묵적인 localhost를 만들고, 그 호스트의 ansible_connection을 local로, ansible_python_interpreter를 지금 ansible-playbook을 실행 중인 파이썬(sys.executable)으로 정한다(lib/ansible/inventory/data.py의 _create_implicit_localhost). local 연결 플러그인은 SSH 대신 subprocess.Popen으로 명령을 실행하므로(lib/ansible/plugins/connection/local.py), AnsiballZ로 포장된 ec2_instance 모듈은 컨트롤 노드의 임시 디렉터리에서 실행되고 AWS SDK인 boto3로 EC2 API를 호출한다. 모듈을 보내고 결과를 JSON으로 받는 구조는 그대로지만 "관리 노드"가 자기 자신이 된 셈이고, 실제로 바뀌는 대상은 그 노드가 아니라 API 너머의 클라우드다. 모양만 보면 테라폼 코어 옆에서 프로바이더가 API를 호출하는 구조와 같아진다.
그림 13. 클라우드 자원을 만드는 플레이북의 실행 흐름. 모듈은 SSH로 전송되지 않고 컨트롤 노드에서 실행되며, 바뀌는 것은 API 너머의 클라우드 자원이다.
둘째, "현재 상태"를 찾는 방법이 검색이 된다. 서버 위의 파일이라면 경로가 곧 자원의 정체였지만, 클라우드의 인스턴스는 만들어진 뒤에야 ID가 생긴다. 상태 파일이 없는 앤서블은 지난번에 만든 인스턴스의 ID를 기록해 두지 않았으므로, 매 실행마다 API로 조건에 맞는 인스턴스를 검색해 그 결과를 현재 상태로 삼는다. ec2_instance는 filters를 따로 주지 않으면 build_filters에서 서브넷, Name 태그, AMI, 그리고 종료되지 않은 상태(pending, running, stopping, stopped)로 필터를 만들어 DescribeInstances를 호출한다. 그다음 exact_count가 있으면 enforce_count가 찾은 개수와 원하는 개수를 비교한다.
    current_count = len(existing_matches)
    if current_count == exact_count:
        # ...
        return dict(
            changed=False,
            # ...
            msg=f"{exact_count} instances already {desired_module_state}, nothing to do.",
        )

    if current_count < exact_count:
        # launch instances
        results = ensure_present(
            # ...
        )
    else:
        # terminate instances
        to_terminate = current_count - exact_count
        # sort the instances from least recent to most recent based on launch time
        existing_matches = sorted(existing_matches, key=lambda inst: inst["LaunchTime"])
개수가 같으면 changed=False로 끝나고, 모자라면 모자란 만큼 만들고, 남으면 가장 먼저 시작된 인스턴스부터 종료한다. 앞에서 본 "조사 → 비교 → 다를 때만 변경 → changed 보고" 규약이 클라우드 API 위에서 그대로 반복되는 것이다.
여기서 중요한 것은 테라폼의 상태 파일이 하던 일, 즉 "설정의 이 자원이 클라우드의 저 객체다"라는 대응을 맡는 것이 검색 조건, 그중에서도 태그라는 점이다. 같은 플레이북을 다시 실행하면 Name=web-server인 인스턴스가 이미 하나 있으므로 아무것도 만들지 않는다. 하지만 name을 web-01로 바꾸면 기존 인스턴스는 더 이상 필터에 걸리지 않으므로 찾은 개수가 0이 되어 새 인스턴스가 하나 더 생기고, 옛 인스턴스는 아무도 기억하지 못한 채 남는다. 누군가 콘솔에서 태그를 지운 경우도 마찬가지다. 테라폼이었다면 같은 리소스 주소에 기록된 객체 ID로 그 인스턴스를 다시 읽어, 앞의 경우는 태그만 고치는 Update로, 뒤의 경우는 드리프트로 다뤘을 것이다.
이 차이가 앤서블로 클라우드를 프로비저닝할 수 없다는 뜻은 아니다. 테라폼이 상태 파일과 그래프로 엔진 안에서 해결한 자원의 정체성과 자원 사이의 순서를, 앤서블에서는 모듈의 검색 조건과 플레이북의 태스크 순서로 작성자가 직접 설계해야 한다는 뜻이다. 이렇게 만든 인스턴스를 다음 플레이의 대상으로 삼을 때도 같은 원리가 적용된다. register한 결과로 add_host를 호출해 인벤토리에 넣거나, amazon.aws.aws_ec2 인벤토리 플러그인으로 태그를 기준으로 호스트를 실행 시점에 모은다. 어느 쪽이든 "어떤 인스턴스가 우리 것인가"는 실행할 때마다 API에 다시 묻는다.
플레이북부터 호스트 변경까지
지금까지의 과정을 한 장으로 모으면 다음과 같다.
그림 14. 플레이북에 적힌 절차가 실제 호스트의 변경이 되기까지의 경로. 테라폼의 상태 파일 자리에는 실행 중에만 유지되는 변수 저장소가 있다.
절차적 방식이 실제 변경과 연결되는 지점도 세 군데로 요약된다. 첫째, 플레이북에 적힌 순서가 그대로 실행 순서가 되고, 호스트마다 커서를 둔 상태 기계와 lock-step 전략이 그 순서를 여러 호스트에 걸쳐 지킨다. 둘째, 현재 상태와의 비교는 엔진이 아니라 모듈 안에서 일어나며 엔진은 모듈이 보고한 changed를 (changed_when으로 덮어쓰지 않는 한) 그대로 받아들여 핸들러에게 통지할 때와 집계할 때, 그리고 출력할 때 쓸 뿐이다. 셋째, 그 모듈을 실행할 때마다 관리 노드로 보내 실행하므로 관리 노드에는 파이썬 인터프리터 외에 앤서블을 설치해 둘 필요가 없다.
선언적 방식과 나란히 놓고 보면
두 도구의 차이를 구현 수준에서 다시 정리하면 다음과 같다.
| 질문 | 테라폼 | 앤서블 |
|---|---|---|
| 현재 상태는 어디서 오는가 | 상태 파일과 매 실행의 새로고침 | 매 실행의 팩트 수집과 각 모듈의 조사 (상태 파일 없음) |
| 실행 순서는 누가 정하는가 | 참조 관계로 만든 DAG | 플레이북에 적힌 순서 (리스트 위치) |
| 비교는 어디서 일어나는가 | 코어가 리소스마다 프로바이더에 PlanResourceChange를 묻고 GetAction으로 판정 | 각 모듈 안에서 (엔진은 changed를 읽기만 함) |
| 실제 변경은 누가 하는가 | 별도 프로세스인 프로바이더가 API 호출 | 관리 노드로 전송된 모듈이 직접 수행 (클라우드 모듈은 컨트롤 노드에서 API 호출) |
| 실패하면 | 의존하는 정점을 건너뛰고 상태에 기록 | 그 호스트의 커서를 rescue 구역으로 옮김 (없으면 그 호스트만 멈춤, 롤백 없음) |
| 자원을 없애려면 | 설정에서 지우면 상태와 비교해 삭제 정점이 생김 (OrphanResourceInstanceTransformer) | state: absent 태스크를 새로 적어야 함 |
| 클라우드 자원의 정체성 | 상태 파일에 기록된 리소스 주소와 객체 ID의 대응 | 모듈의 검색 조건 (Name 태그 등) |
| 미리보기 | plan: 별도의 계획 단계이며, 저장한 계획을 그대로 적용할 수 있음 | --check: 모듈 인수에 실려 가는 실행 모드이며, 지원하지 않는 모듈은 건너뜀 |
| 병렬성의 단위 | 리소스 정점 (세마포어, 기본 10) | 호스트 (forks, 기본 5), 태스크 사이는 lock-step |
이 차이는 두 도구가 자주 함께 쓰이는 이유이기도 하다. 테라폼이 서버를 만들면 앤서블이 그 서버 위에 소프트웨어를 설치하고 구성한다. 또는 불변 인프라immutable infrastructure 패턴1을 따라 Packer로 소프트웨어가 미리 설치된 이미지를 만들고 테라폼이 그 이미지로 서버를 배포하기도 한다. 어느 쪽이든 코드로 적힌 인프라가 실제가 되기까지의 경로는 선언을 절차로 번역하는 엔진과 절차를 적힌 대로 실행하는 엔진 중 하나를 지난다.
마치며
처음에 꼽은 세 문제로 돌아가 보자.
- 재현 불가능성: 테라폼은 설정과 새로고침한 실제 상태를 비교해 필요한 변경만 계산하고, 앤서블은 모듈마다 조사와 비교를 거친 뒤에만 바꾼다. 어느 쪽이든 같은 코드를 빈 계정이나 새 서버에 실행하면 같은 결과로 수렴하고, 이미 원하는 상태인 환경에서는 아무것도 하지 않는다. 재현성은 결국 이 멱등성에서 나온다.
- 감사 불가능성: 인프라의 변경이 코드의 변경이 되면 누가 언제 무엇을 바꿨는지는 버전 관리 시스템의 커밋 이력으로 남고, 문제가 생기면 알려진 이전 상태로 되돌아갈 수 있다(Kim et al., 2021). 테라폼의
plan과 앤서블의--check --diff는 그 변경이 실제로 무엇을 바꿀지를 적용하기 전에 리뷰할 수 있게 해 준다. 다만 이 기록은 코드 밖에서의 변경이 없을 때만 완전하다. 드리프트를 경계해야 하는 이유가 여기에 있다. - 확장 불가능성: 테라폼은 서로 참조하지 않는 리소스를 그래프 위에서 동시에 처리하고, 앤서블은
forks만큼의 호스트에서 같은 태스크를 동시에 실행한다. 서버 10개와 100개의 차이는count값 하나, 또는 인벤토리 몇 줄의 차이가 된다.
두 도구의 내부를 따라가 보면 선언적·절차적이라는 구분이 처음 생각한 것만큼 단순하지 않다는 것도 알 수 있다. 두 도구 모두 결국 현재 상태를 읽고, 원하는 상태와 비교하고, 다를 때만 바꾼다는 같은 고리를 돌린다. 차이는 그 고리를 엔진이 인프라 전체에 대해 돌리는가(테라폼), 아니면 모듈이 자원 하나에 대해 돌리고 그 사이의 순서를 사람이 정하는가(앤서블)에 있다. 그래서 테라폼은 상태 파일과 그래프라는 장치를 얻는 대신 그 상태 파일을 지키고 공유하는 부담을 지고, 앤서블은 관리할 기록이 없는 대신 자원의 정체성과 순서를 작성자에게 맡긴다.
인프라를 코드로 적는 것은 시작일 뿐이다. 그 코드가 소프트웨어라면 소프트웨어처럼 테스트할 수 있어야 하고(Infrastructure Code Testing), 변경이 반드시 코드를 거쳐서만 반영되도록 흐름을 강제할 수도 있다(GitOps). 두 주제는 각각의 글에서 이어서 다룬다.
출처
- Ansible (2026) amazon.aws (소스 코드,
13.0.0-dev0, 커밋1ebe790). Available at: https://github.com/ansible-collections/amazon.aws - Ansible Project (2026) README.md.
ansible/ansible저장소, 커밋f7319e0. Available at: https://github.com/ansible/ansible/blob/f7319e09448e13fa2bc407a1afcd8990f47040fb/README.md - Ansible Project (2026) ansible-core (소스 코드,
2.23.0.dev0, 커밋f7319e0). Available at: https://github.com/ansible/ansible - HashiCorp (no date a) Backend type: s3. Available at: https://developer.hashicorp.com/terraform/language/backend/s3 (Accessed: 21 October 2026).
- HashiCorp (no date b) Upgrading to Terraform v1.11. Available at: https://developer.hashicorp.com/terraform/language/v1.11.x/upgrade-guides (Accessed: 21 October 2026).
- HashiCorp (2026) Terraform Core Architecture Summary.
hashicorp/terraform저장소docs/architecture.md, 커밋8a97fe6. Available at: https://github.com/hashicorp/terraform/blob/8a97fe6c624fa129d5d8246a063c528482fe436c/docs/architecture.md - HashiCorp (2026) Terraform Resource Instance Change Lifecycle.
hashicorp/terraform저장소docs/resource-instance-change-lifecycle.md, 커밋8a97fe6. Available at: https://github.com/hashicorp/terraform/blob/8a97fe6c624fa129d5d8246a063c528482fe436c/docs/resource-instance-change-lifecycle.md - HashiCorp (2026) Terraform (소스 코드,
1.18.0-dev, 커밋8a97fe6). Available at: https://github.com/hashicorp/terraform - Kim, G. et al. (2021) The DevOps handbook: how to create world-class agility, reliability, & security in technology organizations. Second edition. Portland, OR: IT Revolution Press.
각주
-
불변 인프라(immutable infrastructure) 패턴은 서버를 한 번 배포한 뒤 수정하지 않는다는 원칙이다. 변경이 필요하면 새 AMI를 만들어 새 서버를 배포하고 기존 서버를 삭제한다. 서버 상태가 누적되지 않아 예측 가능성이 높아지고, 드리프트 문제가 원천적으로 해소된다. 『데브옵스 핸드북』은 이를 "고치는 것보다 다시 만드는 것이 쉬운 인프라"라는 원칙의 한 형태로 설명하며, 운영 환경을 수동으로 바꾸는 것을 금지하고 모든 변경을 버전 관리를 거쳐 환경을 처음부터 다시 만드는 방식으로만 반영하는 패턴이라고 정의한다(Kim et al., 2021). ↩ ↩2
-
HashiCorp는 2023년 8월 테라폼을 포함한 자사 제품의 라이선스를 MPL(Mozilla Public License) 2.0에서 BSL(Business Source License)로 바꾼다고 발표했다. 이에 반발한 커뮤니티가 MPL 시절의 코드를 포크해 OpenTF를 만들었고, 이 프로젝트는 같은 해 9월 OpenTofu로 이름을 바꿔 리눅스 재단(Linux Foundation) 산하로 옮겨졌다(Wikipedia, Terraform (software): 라이선스 변경과 OpenTofu 포크의 경위를 정리한 항목). OpenTofu는 테라폼에서 갈라져 나왔으므로 이 글에서 설명하는 코어와 프로바이더의 구조는 대체로 두 도구에 공통이다. 한편 HashiCorp는 2025년 2월 IBM에 64억 달러에 인수되었다(TechRepublic: IBM이 2025년 2월 28일 인수를 완료했다고 보도한 기사). ↩
-
Terraform 프로바이더(provider)는 특정 플랫폼의 API와 통신하는 플러그인이다.
hashicorp/aws,hashicorp/google,hashicorp/azurerm등이 공식 프로바이더이며, Terraform Registry에서 설치한다. 프로바이더는 리소스 타입과 데이터 소스를 정의한다. ↩ -
테라폼 워크스페이스는 하나의 설정 디렉터리와 백엔드 안에서 서로 독립된 상태를 여러 벌 두기 위한 이름이다. 처음에는
default워크스페이스 하나만 있고,terraform workspace new나terraform workspace select로 워크스페이스를 만들거나 바꾸면 같은 설정이 워크스페이스마다 다른 상태에 연결된다.local백엔드에서default의 상태는terraform.tfstate에, 나머지 워크스페이스의 상태는terraform.tfstate.d/<워크스페이스 이름>/아래에 저장된다(internal/backend/local/backend.go의DefaultWorkspaceDir). ↩ -
상태 파일은 Terraform이 관리하는 인프라의 스냅샷이다. 리소스 ID, 속성, 의존성 등이 기록된다. 상태 파일에는 민감한 정보(비밀번호, API 키)가 포함될 수 있으므로 암호화해서 보관해야 한다.
.gitignore에terraform.tfstate를 추가해 Git에 커밋되지 않도록 해야 한다. ↩ -
원격 상태remote state는 상태 파일을 팀이 공유하는 저장소에 보관하는 방식이다. AWS에서는 S3 버킷에 상태 파일을 저장하고, DynamoDB 테이블로 잠금을 구현하는 것이 오랫동안 표준 패턴이었다. 잠금이 없으면 두 사람이 동시에
apply를 실행할 때 상태 파일이 손상될 수 있다. 테라폼 1.10에서 DynamoDB 없이 S3의 조건부 쓰기를 이용하는 자체 잠금(use_lockfile)이 도입되었고, 1.11에서 이 S3 네이티브 잠금이 정식 기능이 되면서 DynamoDB 관련 인수(dynamodb_table등)는 지원 중단deprecated되었다(HashiCorp, no date b). 공식 문서는 DynamoDB 기반 잠금이 향후 마이너 버전에서 제거될 예정이라고 밝히고 있으며(HashiCorp, no date a), 이 글이 기준으로 삼은 커밋에서도dynamodb_table을 지정하면use_lockfile을 쓰라는 지원 중단 경고가 나온다(internal/backend/remote-state/s3/backend.go). 잠금 파일은 상태 파일 이름에.tflock을 붙인 객체로 같은 버킷에 만들어진다(internal/backend/remote-state/s3/backend_state.go). ↩ -
이 절의 파일 경로·함수 이름·코드 인용은
hashicorp/terraform저장소main브랜치의 커밋8a97fe6(2026-10-19,1.18.0-dev)을 기준으로 한다. 이 저장소는 테라폼 코어(CLI와 그래프 엔진)의 Go 소스 코드만 담고 있으며 프로바이더는 포함하지 않는다. 내부 패키지(internal/)는 공개 API가 아니므로 이후 버전에서 이름이나 위치가 바뀔 수 있다. ↩ -
테라폼에서 백엔드는 테라폼이 상태를 어디에 저장하고 작업을 어디서 실행할지 결정하는 계층이다. 기본값인
local백엔드는 상태를 작업 디렉터리의terraform.tfstate에 저장하고 작업도 로컬에서 실행하며, 작업을 시작하기 전에 상태 잠금을 먼저 획득한다(internal/backend/local/backend_local.go). 앞서 다룬 S3 원격 상태도 이 계층에서 구현된다. ↩ -
gRPC(gRPC Remote Procedure Calls)는 Protocol Buffers로 정의한 서비스 인터페이스를 HTTP/2 위에서 호출하는 RPC(Remote Procedure Call, 원격 프로시저 호출) 프레임워크다. 테라폼은 HashiCorp의
go-plugin라이브러리로 프로바이더 프로세스를 띄우고 gRPC 연결을 맺으며, 프로바이더가 구현해야 할 RPC는 저장소의docs/plugin-protocol/tfplugin6.proto에 정의되어 있다. 이.proto파일만 구현하면 어떤 언어로든 프로바이더를 만들 수 있다. ↩ -
MessagePack은 JSON과 비슷한 데이터 모델을 더 작은 바이너리로 표현하는 직렬화 형식이다. 테라폼의 객체 전송 형식 문서에 따르면, null은 MessagePack의 nil로, 적용 전까지 값을 알 수 없는 unknown 값은 MessagePack 확장 타입으로 표현된다. JSON에는 "아직 모르는 값"을 나타낼 방법이 없기 때문에 이런 형식이 필요하다. ↩
-
참조로 드러나지 않는 의존성, 예컨대 IAM(Identity and Access Management, 자격 증명 및 액세스 관리) 정책이 연결된 뒤에야 제대로 동작하는 인스턴스 같은 관계가 있을 때는
depends_on인수로 간선을 직접 추가한다. 이 인수도 별도의 장치가 아니다.NodeAbstractResource.References가 표현식의 참조 목록에DependsOn()의 결과를 덧붙이므로(internal/terraform/node_resource_abstract.go),ReferenceTransformer는 두 경우를 똑같이 간선으로 바꾼다. 관계에서 순서를 얻는 이 문제는 그래프 이론의 위상 정렬topological sort과 같으며, 순환이 없는 그래프에서만 답이 존재한다. ↩ -
고루틴은 Go 런타임이 관리하는 경량 실행 단위다. 운영체제 스레드보다 생성 비용이 훨씬 작아 수천 개를 띄워도 부담이 적고, Go 런타임이 소수의 OS 스레드 위에 고루틴들을 나눠 실행한다. ↩
-
프로바이더 스키마에서
computed로 표시된 속성은 사용자가 아니라 프로바이더(또는 원격 시스템)가 값을 정한다. EC2 인스턴스의id나private_ip처럼 객체가 생성된 뒤에야 알 수 있는 값이 대표적이다.optional과computed가 함께 붙은 속성은 사용자가 적으면 그 값을, 적지 않으면 프로바이더가 고른 값을 쓴다(HashiCorp, Terraform Resource Instance Change Lifecycle). ↩ -
lifecycle { create_before_destroy = true }를 지정하면 교체할 때 새 객체를 먼저 만들고 기존 객체를 나중에 지운다(CreateThenDelete). 기본 동작(DeleteThenCreate)은 교체하는 동안 자원이 비는 순간이 생기므로, 로드 밸런서 뒤의 인스턴스처럼 중단을 피해야 하는 자원에 이 옵션을 쓴다. ↩ -
오염된tainted 객체는 생성 도중 실패해 정상 동작을 보장할 수 없는 원격 객체다. 테라폼은 이 객체를 상태에 남겨 두되, 다음 계획에서 이전 상태가 없는 것처럼 취급해 새로 만든 뒤 교체(
Replace) 변경으로 바꾼다(NodeAbstractResourceInstance.plan의ObjectTainted분기). ↩ -
이 성질이 새로고침에 기대고 있다는 것은 새로고침을 끄면 드러난다.
-refresh=false로 계획하면 테라폼은ReadResource를 호출하지 않고 상태 파일의 기록을 그대로 이전 상태로 쓴다(internal/command/arguments/extended.go). 그러면 비교의 기준이 실제 인프라가 아니라 마지막 기록이 되므로, 밖에서 바뀐 것을 놓친 채NoOp을 내릴 수 있다. 큰 설정에서 계획 시간을 줄이려고 쓰는 옵션이지만 그만큼 멱등성의 근거를 내려놓는 셈이다. ↩ -
앤서블은 엔진과
ansible.builtin플러그인·모듈만 담은ansible-core패키지와, 거기에 커뮤니티 컬렉션collection들을 함께 묶은ansible패키지로 나뉘어 배포된다. 이 절에서 살펴보는ansible/ansible저장소는ansible-core이며, AWS나 Docker를 다루는 모듈 같은 컬렉션은 포함하지 않는다. ↩ -
이 절의 파일 경로·함수 이름·코드 인용은
ansible/ansible저장소devel브랜치의 커밋f7319e0(2026-10-17,2.23.0.dev0)을 기준으로 한다. 컨트롤 노드의 엔진(lib/ansible)과 관리 노드로 전송되는module_utils, 내장 모듈이 모두 이 저장소에 있다._internal로 시작하는 패키지는 공개 API가 아니므로 이후 버전에서 이름이나 위치가 바뀔 수 있다. ↩ -
팩트 캐시 플러그인(
fact_caching설정)을jsonfile같은 영속 플러그인으로 바꾸면 호스트별 팩트가 파일로 남아 다음 실행에서도 읽힌다(기본 만료 시간 86400초). 기본값인memory플러그인은 프로세스 안의 사전이라 실행이 끝나면 사라진다. 이것이 앤서블이 실행 사이에 기억할 수 있는 유일한 것이며,register값이나cacheable을 켜지 않은set_fact값은 영속 플러그인을 켜도 남지 않는다. ↩ -
AnsiballZ는 모듈과 그 모듈이 쓰는
module_utils를 zip 하나로 묶어 파이썬 스크립트 한 개에 담는 앤서블의 모듈 전송 형식이다. 한 번 만든 zip은 컨트롤 노드의 실행별 임시 디렉터리(~/.ansible/tmp/ansible-local-<pid>…/ansiballz_cache, 실행이 끝나면 지워진다)에 캐시되어 같은 실행 안에서 재사용되고, 모듈 인수는 캐시에 포함되지 않고 래퍼 스크립트 끝에 매번 새로 적힌다. ↩ -
Jinja2는 파이썬으로 작성된 템플릿 엔진이다.
{{ 변수 }}로 값을 끼워 넣고,{% if %}나{% for %}로 조건과 반복을 표현한다. 앤서블은template모듈이 다루는.j2파일뿐 아니라 플레이북 안의 문자열 값과when조건을 모두 Jinja2로 평가하며, 이 평가는 관리 노드가 아니라 컨트롤 노드에서 일어난다. ↩ -
역할은 태스크, 핸들러, 기본 변수, 템플릿, 파일을
tasks/,handlers/,defaults/,templates/,files/같은 정해진 디렉터리 구조로 묶은 재사용 단위다. 플레이의roles:에 이름을 적으면 그 역할의tasks/main.yml이 플레이의tasks보다 앞에 끼워지고, 역할이meta/main.yml에 선언한 의존 역할은 그보다도 먼저 실행된다. 역할과 모듈, 플러그인을 다시 하나로 묶어 배포하는 단위가 컬렉션이다. ↩ -
상태 기계는 유한한 개수의 상태와, 입력에 따라 한 상태에서 다른 상태로 옮겨 가는 전이 규칙으로 시스템의 동작을 기술하는 모델이다.
HostState에서는run_state가 현재 상태이고, 태스크의 성공·실패와 구역의 끝이 전이를 일으키는 입력이다. ↩ -
파이프라이닝은 모듈 스크립트를 원격 임시 파일로 올리는 대신 SSH 명령의 표준 입력으로 전달해 왕복 횟수를 줄이는 설정(
ANSIBLE_PIPELINING)이다. 기본값이 꺼짐인 것은sudo의requiretty설정이 걸린 호스트에서 표준 입력을 쓸 수 없기 때문이며, become 플러그인이 파이프라이닝을 허용하는지도 함께 검사한다. ↩ -
셔뱅은 스크립트 첫 줄에
#!과 함께 그 스크립트를 실행할 인터프리터의 경로를 적는 관례다(예:#!/usr/bin/python3). 앤서블은 모듈을 포장할 때 이 줄을 그 호스트에서 탐지한 인터프리터 경로로 바꿔 쓰고(_get_ansiballz_code(shebang)), 파이프라이닝 시에는 이 경로를 원격 명령으로 사용한다. ↩ -
SFTP(SSH File Transfer Protocol, SSH 파일 전송 프로토콜)와 SCP(Secure Copy Protocol, 보안 복사 프로토콜)는 모두 SSH 연결 위에서 파일을 옮기는 방법이다. 앤서블
ssh연결 플러그인의ssh_transfer_method기본값은smart로,sftp→scp→piped(양쪽에서dd로 SSH 파이프를 여는 방식) 순서로 시도해 처음 성공한 방법을 쓴다(lib/ansible/plugins/connection/ssh.py). ↩ -
ControlMaster는 첫 SSH 연결을 유닉스 도메인 소켓으로 열어 두고 이후의 연결이 그 소켓을 공유하게 하는 OpenSSH 기능이다. 앤서블ssh연결 플러그인의 기본ssh_args는-C -o ControlMaster=auto -o ControlPersist=60s이므로, 태스크마다 새ssh프로세스를 띄우더라도 같은 호스트에 대한 인증과 키 교환은 처음 한 번만 일어나고 연결은 마지막 사용 후 60초 동안 유지된다. ↩ -
POSIX 셸은 POSIX 표준이 정한 문법과 기본 명령을 지원하는 명령 해석기(보통
/bin/sh)다. 앤서블은 원격 임시 디렉터리 생성, 권한 상승 명령의 래핑, 인터프리터 탐색(command -v) 같은 준비 작업을 이 셸의 명령으로 수행하므로, 파이썬 인터프리터와 함께 관리 노드의 최소 요건이 된다. ↩ -
콜백 플러그인은 플레이 시작, 태스크 결과, 플레이 요약 같은 실행 이벤트를 받아 처리하는 플러그인이다. 화면 출력도 콜백 플러그인 중 하나(
stdout유형)가 맡으므로, 기본값인default콜백을ansible-core에 함께 들어 있는minimal이나oneline으로 바꾸면 같은 실행이라도 출력 형식이 달라진다. ↩ -
이 절의
ec2_instance코드 인용은ansible-collections/amazon.aws저장소main브랜치의 커밋1ebe790(2026-10-20,13.0.0-dev0)을 기준으로 한다. 이 컬렉션의 모듈은 AWS SDK for Python인 boto3에 의존하므로, 모듈이 실행되는 컨트롤 노드에 boto3와 AWS 자격 증명이 준비되어 있어야 한다. ↩