AI가 이미지를 아무렇지 않게 인식하는 이유는 AI가 이미지를 인식하게 하기 위해 지난 수십 년간 치열한 연구가 이루어졌기 때문입니다. 이 분야를 컴퓨터 비전(Computer Vision)이라 부릅니다. 그 컴퓨터 비전에서 빼놓을 수 없는 이름이 바로 CNN(Convolutional Neural Network)입니다. 이번 글에서는 바로 이 CNN에 대해 알아봅니다.
인류는 아주 오래전부터 계산computation이라는 작업을 해왔다. 손으로 어떤 물건의 개수를 세는 일부터 시작해 곡식의 양이나 땅의 크기를 재고, 돈을 셌다. 그 과정에서 주판, 계산자, 안티키테라, 계산기 등이 발명되고 또 사용 되어왔다. 이 기계들은 점점 복잡해지는 계산을 대신해주는 역할을 맡아 인류의 수고를 덜어주었고, 컴퓨터는 바로 이 흐름의 연장선에서 개발되었다. 그래서 초기 컴퓨터는 텍스트와 숫자를 계산하는 연산 장치에 불과했다. 비록 초기 인공지능 연구가 수학 정리를 증명하거나 체스를 두는 영역에서 빠르게 성과를 냈다고는 하나, 인간이 외부 세계와 상호작용하며 받아들이는 정보의 대부분은 시각에서 비롯된다.
그런 점에서 컴퓨터가 인간의 수고를 조금이라도 더 덜어주기 위해서는, 현실 세계의 물리적 환경을 이해하고 자율적으로 동작하기 위해서는 반드시 시각 데이터를 이해해야 한다. 인간이 눈으로 사물이나 사람을 인식하고 정보를 얻듯이, 컴퓨터도 지능적인 측면에서 인간의 시각을 가져야 기존에 사람만으로는 하기 어려웠던 신원 데이터 조회나 이동 경로 추적과 같은 업무를 컴퓨터의 도움을 받아 수행할 수 있게 되는 것이다. 컴퓨터가 물리적 세계를 이해할 수 있도록 시각 데이터를 이해하고 처리할 수 있는 방법을 만드는 컴퓨터 비전이라는 학문은 그렇게 시작됐다.
컴퓨터 비전의 한계
컴퓨터 비전이라는 학문이 처음 시작됐을 때, 사람들은 낙관에 가득 차 있었다. MIT의 래리 로버츠(Larry Roberts, 1937~2018)는 ARPANET의 창시자 중 한 명으로 더 유명하지만, 컴퓨터 비전의 문을 연 첫 인물이기도 하다. 그가 1963년에 쓴 박사 학위 논문인 <Machine Perception of Three-dimensional Solids>에서 2차원 흑백 사진으로부터 3차원 다면체의 기하학적 구조를 복원하는 방법을 제시하고, 실제로 배경과 조명, 그리고 사물을 완벽하게 통제한 환경에서 실험에 성공했다.
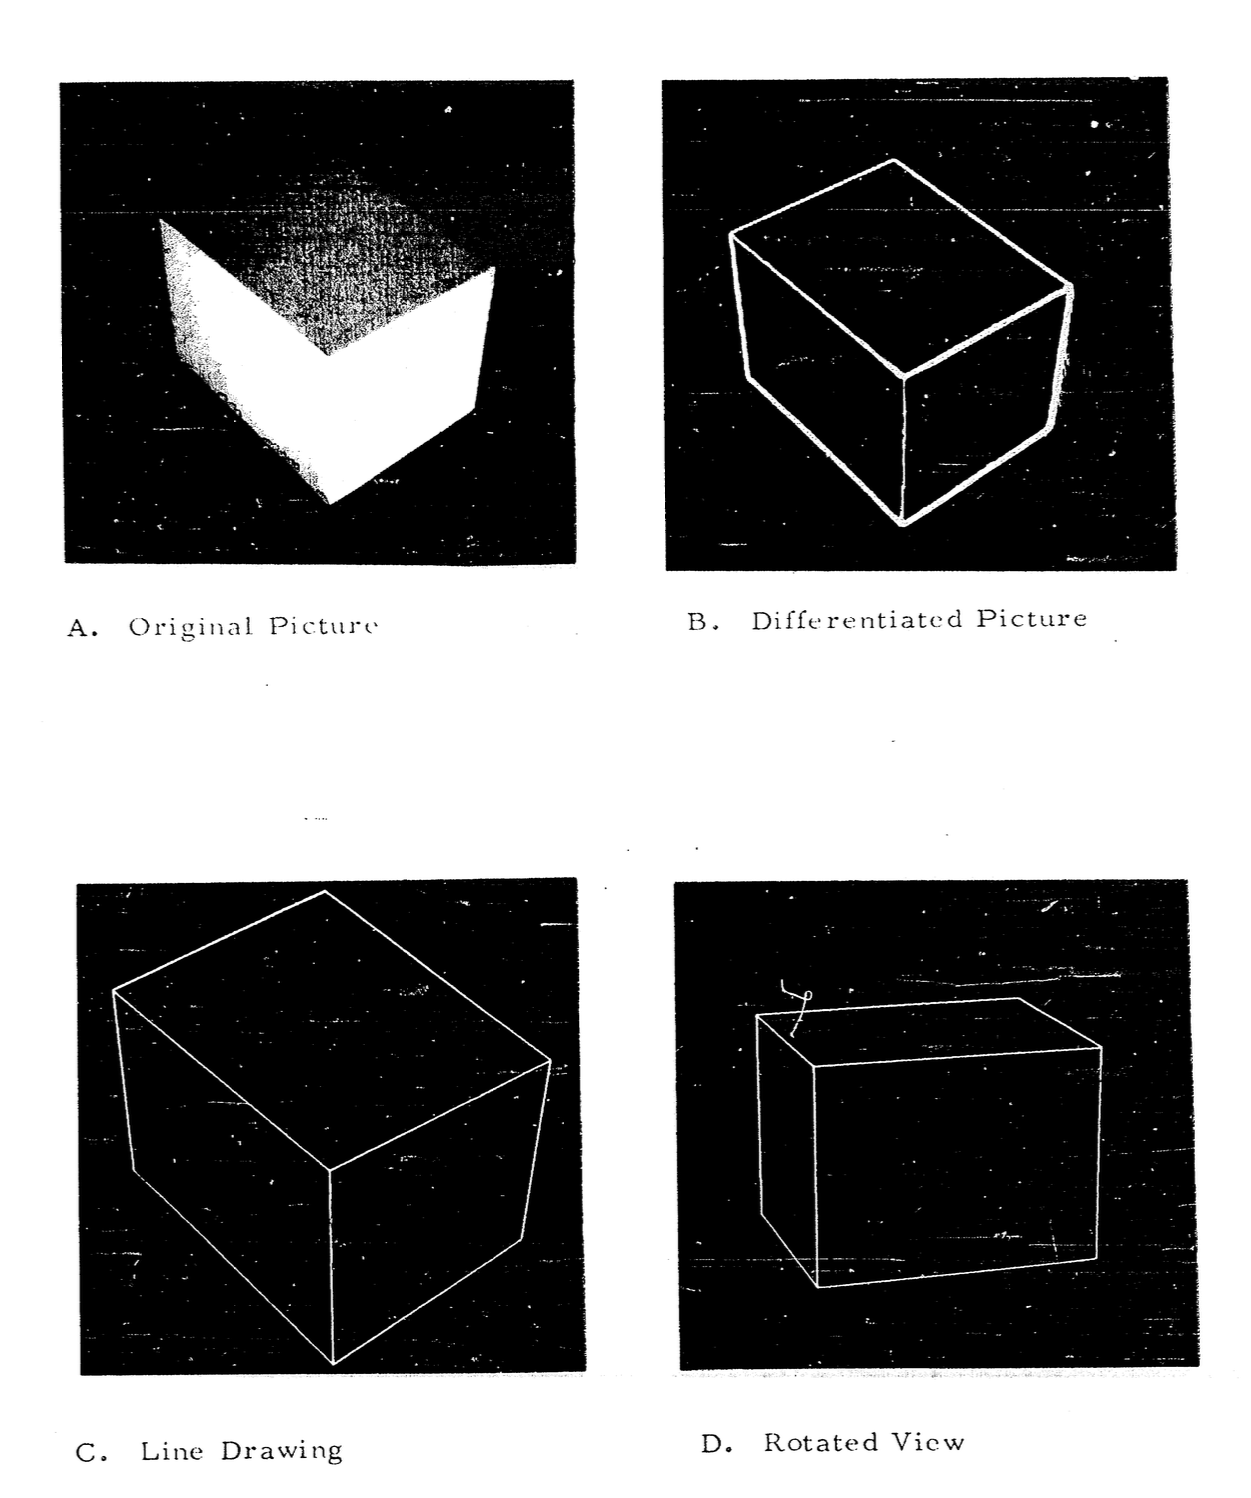 그림 1. <Machine Perceptions of Three-dimensional Solids>에 수록된 실험 기록. 실제 그림(A)을 기하학적 형태(D)로 복원한 것을 알 수 있다.
훗날 퍼셉트론의 한계를 지적한 <Perceptrons>를 함께 쓰게 되는 마빈 민스키(Marvin Minsky)와 시모어 페퍼트(Seymour Papert)는 1966년 여름 비전 프로젝트(Summer Vision Project)를 기획한다. 그들은 학부생들에게 이번 여름방학(6월~8월) 동안 카메라를 컴퓨터에 연결해 배경과 전경을 분리하고, 사진 속 사물들의 이름을 분류하는 범용 시각 시스템을 완성하라는 과제를 냈다. 물론 이 과제는 실패했고, 그 뒤에는 당시 컴퓨터 비전에 대한 학계의 착각이 있었다. 인공지능이 개척한 영역은 인간에게 고도의 사고력과 집중력을 요하는 일이었고, 인간에게 있어 눈으로 어떤 사물을 감지하는 것은 아기조차 쉽게 해내는 일이었기에 비전 프로젝트 또한 학부생에게 과제로 내줄 만큼 쉬운 영역이라 생각했던 것이다.
그렇게 시행착오는 10년 넘게 이어지다 MIT의 신경과학자 데이비드 마(David Marr, 1945~1980)가 그동안의 비전 연구를 집대성하고 작은 특징부터 시작해 인식을 쌓아올리는 방식의 3단계 시각 처리 파이프라인을 제시하면서 마무리되는 듯했다. 기초적인 기하학적 특징을 추출하고, 관찰자 시점을 기준으로 한 각 표면의 법선 벡터와 깊이 불연속성 지도를 만들고, 관찰자의 시점과 독립적인 3차원 원기둥들이 계층적으로 조립되는 구조로 사물을 재구성하는 파이프라인이 만들어지고 기하학적 특징을 추출하기 위한 수학적 검출기들이 만들어졌다.
그럼에도 불구하고, 실제 세계 앞에서 컴퓨터 비전은 이렇다 할 성과를 거두지 못했다. 인간의 뇌는 조명이 어두워지거나 촬영 각도가 틀어져도 사과를 여전히 사과로 인식하지만, 컴퓨터에게 깊이에 대한 정보가 사라진 디지털 이미지는 그저 숫자로 채워진 거대한 2차원 행렬일 뿐이다. 파이프라인에 오차가 생기면 그 오차는 다음 단계로 넘어가 새로운 오차를 만들어냈다. 피사체가 단 몇 픽셀만 이동하거나 그림자가 지기만 해도 행렬을 구성하는 숫자 배열은 완전히 달라지고, 개발자가 직접 윤곽선이나 모서리를 찾는 수학 공식을 짜서 넣는 방식으로는 현실 세계의 무한한 시각적 변형을 도저히 감당할 수 없었다.
영감은 외부에서 온다
고양이 실험
아이러니하게도 CNN의 핵심 설계도가 된 실험은 컴퓨터공학이 아닌 순수 신경생리학 및 의학 분야에서 시작됐다. 하버드 대학교의 데이비드 허벨(David Hubel)과 토르스텐 비젤(Torsten Wiesel)은 사시나 약시 같은 시각 장애를 연구하며, 망막에 맺힌 단순한 빛의 점들이 대뇌 시각 피질Visual Cortex에서 어떻게 조합되어 구체적인 형태로 인식되는지 알아내고자 했다. 이를 위해 두 연구자는 마취된 고양이의 뇌에서 시각을 담당하는 것으로 알려진 영역에 미세 기록 전극Recording electrode을 꽂고, 화면을 통해 다양한 시각 자극Stimulus을 보여주며 뉴런에서 발생하는 전기 신호를 측정했다.
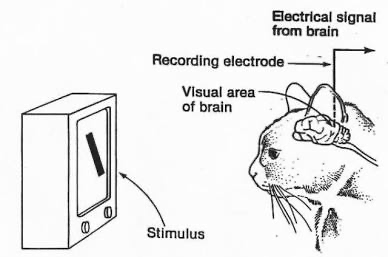 *그림 2. CNN의 기반 중 하나가 된 시각 자극에 관한 실험을 나타낸 그림. 이 그림은 원 논문인
1959년에 최초로 이루어진 실험과 그 후 이루어진 후속 연구를 통해 그들은 고양이의 시각피질이 어떤 자극에 어떻게 반응하는지 밝혀냈는데, 구체적으로는 다음과 같다:
- 고양이의 1차 시각피질Striate Cortex에 있는 뉴런은 특정 각도로 기울어진 선에만 반응한다.
- 시각 피질의 개별 뉴런은 시야 전체를 한꺼번에 처리하지 않고, 시야의 아주 좁은 국소 영역에서 들어오는 자극에만 반응한다.
- 좁은 영역의 단순한 선분을 감지하는 단순 세포의 출력이 모여, 자극의 위치가 조금 이동하더라도 동일한 형태로 인식하는 복잡 세포로 전달된다. 즉, 점 → 선 → 윤곽 → 복잡한 물체 순으로 특징이 조립된다.
Neocognitron
이 연구 결과에 영감을 받아 당시 일본 NHK 기상관측 과학연구소에 있던 후쿠시마 쿠니히코(福島邦彦, 1936~)는 1980년 네오코그니트론(Neocognitron)이라는 인공 신경망 모델을 발표한다. 이 모델의 가장 큰 특징은 입력 데이터가 S세포와 C세포라는 서로 다른 두 계층을 번갈아가며 통과한다는 것이었는데, S세포에서는 시각 데이터의 특징을 추출하고 C세포에서는 같은 물체여도 위치에 따라 인식 결과가 달라지는 문제를 해결하기 위해 위치 이동에 따른 차이를 보정한다.
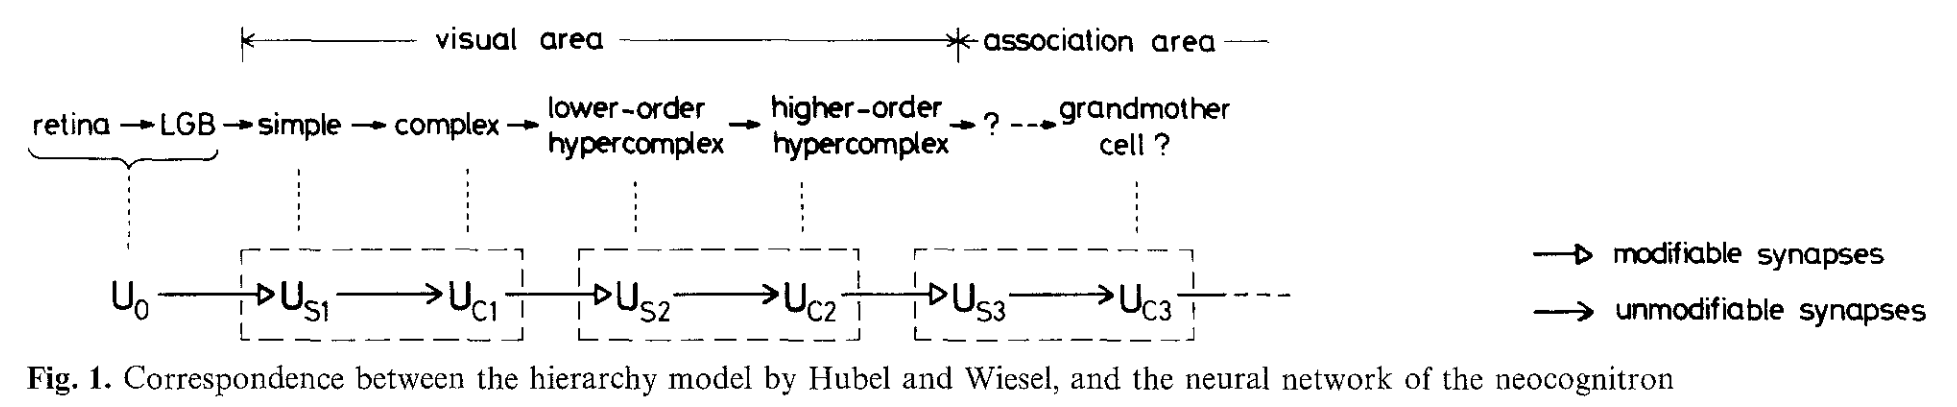 *그림 3. 네오코그니트론의 구조를 간략하게 나타낸 다이어그램. S세포와 C세포가 번갈아 나타나는 것을 확인할 수 있다.*
그림 3에서 보이듯이, 네오코그니트론은 입력 계층input layer 뒤로 S세포와 C세포를 묶은 모듈이 계속 이어지는 구조다. 모듈 내의 연결은 바뀌지 않지만 모듈과 모듈 사이의 연결은 학습 과정에서 계속 바뀐다.
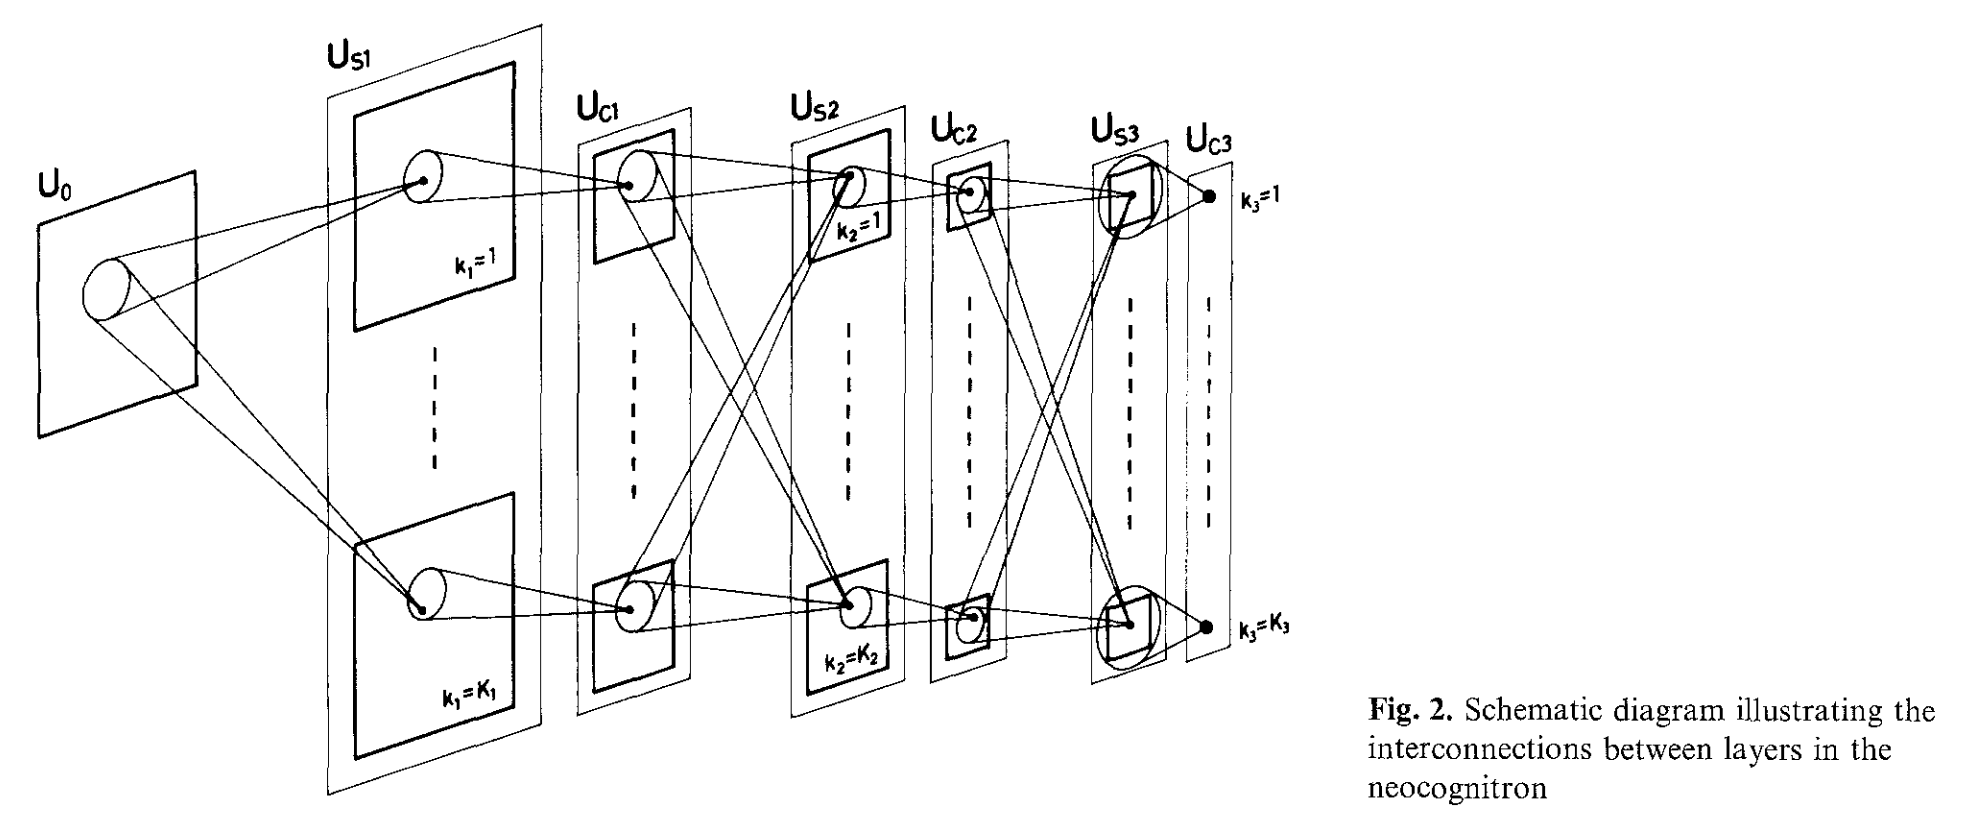 *그림 4. 네오코그니트론의 구조를 조금 더 자세히 나타낸 다이어그램. 이 그림에서는 계층 간의 상호작용이 어떻게 이루어지는지 볼 수 있다.*
그림 4를 통해 그 구조를 조금 더 자세히 들여다 볼 수 있는데, 번째 모듈의 S계층()는 입력으로 주어진 영역 중 일부에서 어떤 시각적 특징을 추출한다. 이 시각적 특징은 선의 방향일 수도 있고, 모서리일 수도 있고, 교차점일 수도 있다. 어쨌든 S세포는 특정한 시각적 특징에만 반응하도록 되어 있어서 유사한 패턴을 구별한다. 그렇다면 S세포가 모인 S계층은 어떻게 입력 전체를 인식하는 걸까?
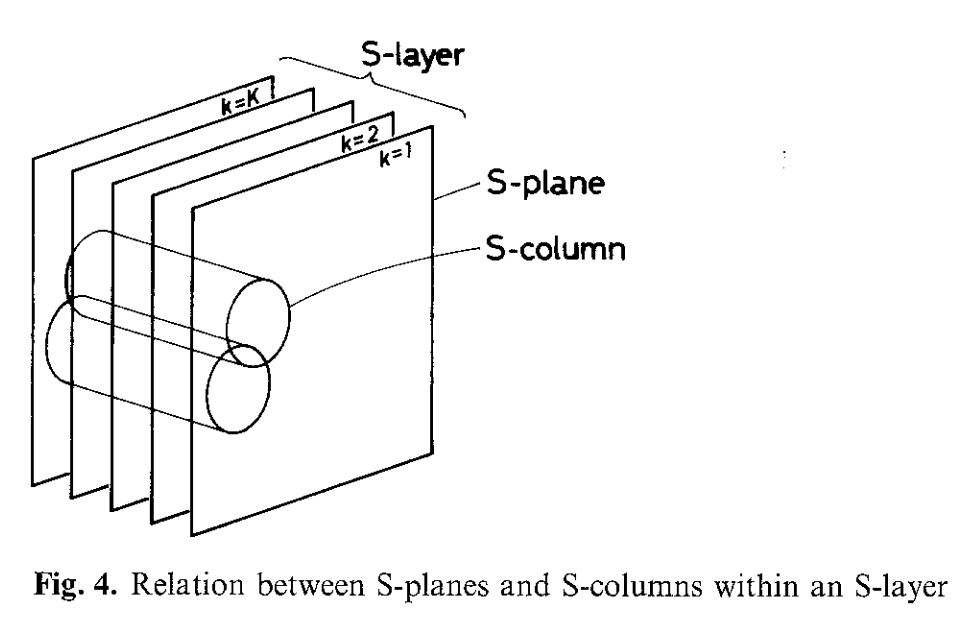 *그림 5. S세포가 구성하는 원기둥(S-column)과 평면(S-plane), 그리고 S계층(S-layer) 사이의 관계.*
그림 5를 통해 S계층 안에서 S세포가 어떻게 배치되어 있는지 확인할 수 있다. 그림 4에서는 S계층을 S평면이 세로로 나열된 모습으로 표현했는데, 그림 5에서는 S평면을 겹쳐 놓아 S계층을 표현했다. 하나의 S평면에 속한 S세포끼리는 동일한 특징을 추출하고 각각 맡는 영역이 다르다. 그래서 입력 자극이 공간적으로 평행 이동하면 기존에 반응하던 S세포 대신 동일한 S평면 내에서 위치가 이동된 다른 S세포가 대신 반응한다.
반면 S-column에서는 다른 상황이 펼쳐진다. S-column을 구성하는 S세포들은 서로 다른 S평면에 위치하기 때문에 각자 포착하는 시각적 특징이 다르지만, 그 특징을 포착하는 영역이 거의 동일하다. 그렇기 때문에 S-column은 하나의 영역에서 서로 다른 시각적 특징을 모두 포착하는 역할을 수행하고 S평면은 입력 전체에서 특정 시각적 특징을 포착하는 역할을 수행한다. 이를 통해 S계층이 어떻게 입력 전체에 존재하는 모든 시각적 특징을 포착한다는 것을 알 수 있다.
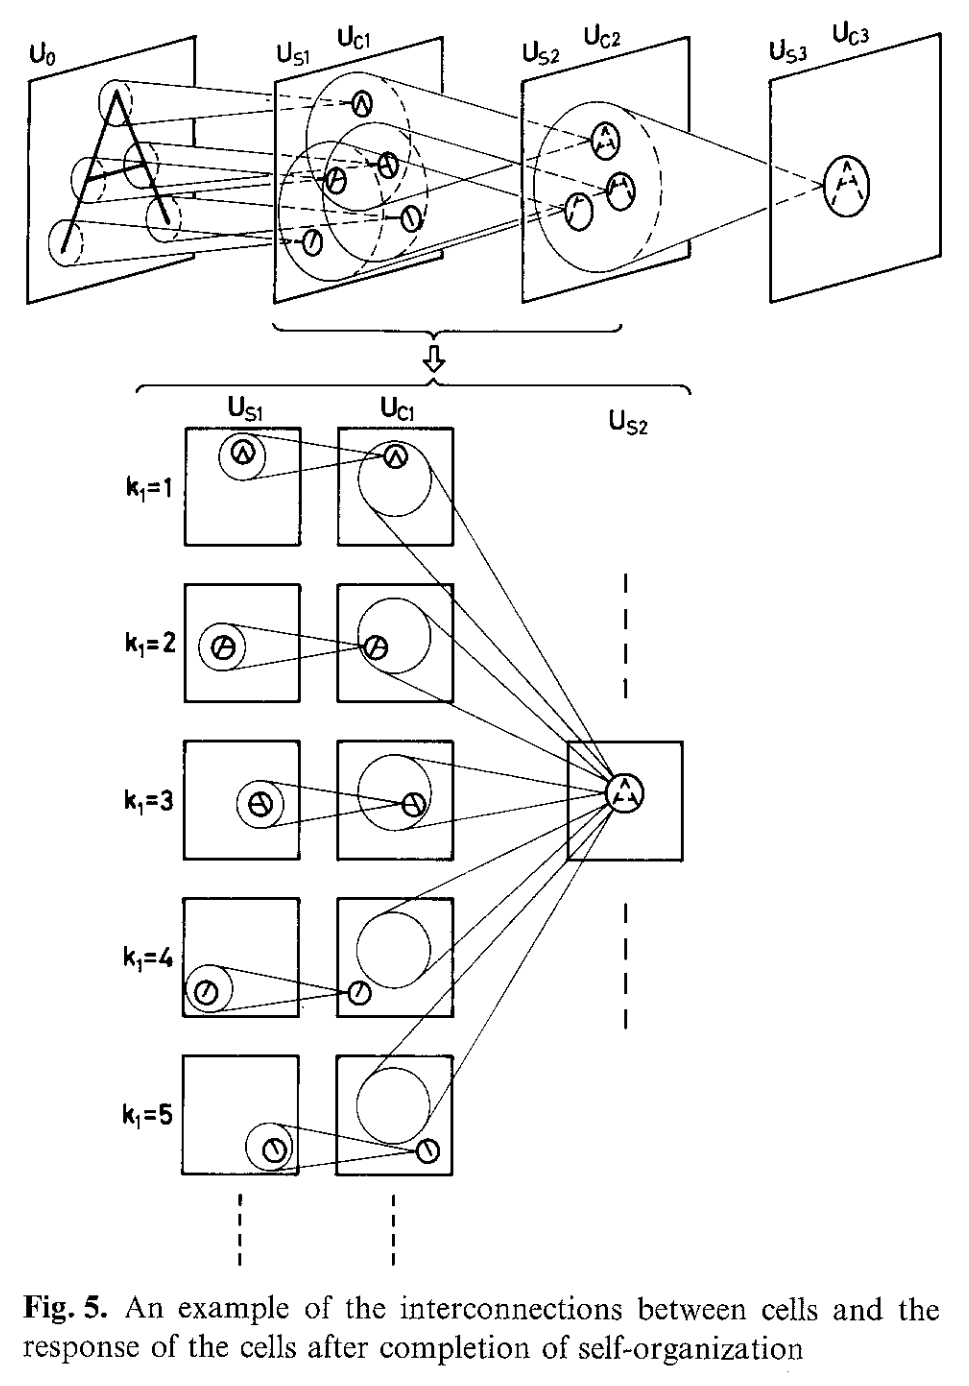 *그림 6. 네오코그니트론에서 인식이 이루어지는 과정.*
그렇다면 C세포는 어떤 역할을 할까? C계층은 S계층과 비슷하게 여러 개의 C평면으로 나뉘어 있는데, 번째 모듈의 C계층()은 과 연결되어 있는데, 이때 평면의 번호 이 일치하는 S평면과 C평면이 연결되어 있다. S평면은 전체 입력에서 특정한 특징을 추출하기 때문에 C평면에 주어지는 입력은 S평면이 감지한 특징이다.
하나의 C평면에 위치한 모든 C세포는 대응하는 S평면의 특정 영역으로부터 입력을 받는데, 그 영역에 속하는 S세포 중 하나만 강하게 반응해도 C세포는 강하게 반응한다. 그래서 입력 패턴이 약간 이동하여 원래 반응하던 S세포 대신 바로 옆의 다른 S세포가 반응하더라도 두 S세포 모두 동일한 C세포가 감지하는 영역에 있다면 C세포의 반응은 동일하다. 즉, C세포가 하는 일은 S세포를 통해 이루어진 시각적 특징의 추출에 공간적 유연성을 부여하는 일이다. 또한 C세포 하나가 여러 개의 S세포로부터 입력을 받기 때문에 C세포 하나가 감지하는 영역은 점점 커지고, 마지막 모듈에서는 C모듈의 각 C평면마다 하나의 C세포만 남게 되며, 이 C세포가 전체를 포괄한다. 이 외에도 C세포는 입력 신호가 특정 영역에서 폭주하지 않도록 조절하는 역할도 담당한다.
지금까지의 내용을 통해 네오코그니트론의 각 모듈에서 S계층이 시각적인 특징을 찾아내면 C계층이 시각적 변형을 반영하는 것을 확인했다. 그림 6은 이 과정을 간략하게 나타낸 것이다. 이렇게 많은 모듈을 거치게 되면 최종적으로 자극의 입력 위치나 크기, 형태 왜곡에 영향을 받지 않고 특정 패턴에만 선택적으로 반응하게 되는데, 이 구조가 CNN의 구조에 큰 영향을 끼치기 때문에 잘 기억해두는 것이 좋다.
Neural Network In Brief
여기서 인공 신경망(Neural Network 혹은 Artificial Neural Network)라는 또다른 분야를 짧게나마 다루고 갈 필요가 있다. 기계학습Machine Learning이라는 분야에서 컴퓨터는 수많은 예시를 통해 세상을 학습하고 모델을 만든다. 그리고 그 모델은 이 세상을 모방한 가설hypothesis인 동시에 문제를 해결하는 소프트웨어의 일부다. 이 모델이 마치 뉴런과 시냅스로 구성된 인간의 두뇌처럼 변화할 수 있는 연결선을 지닌 복잡한 회로의 형태를 지닌다면 그런 모델을 인공 신경망이라 부르고 그런 모델을 훈련시키기 위한 기술들을 합쳐 딥러닝(Deep Learning)이라 부른다.
Fully Connected Neural Network
딥러닝의 기본적인 아이디어는 연산 경로가 긴 회로를 훈련시켜 모든 입력값이 다양한 방법으로 상호작용할 수 있도록 하는 것인데, 이는 인공 신경망은 여러 개의 층layer을 가지기 때문이다. 그리고 그런 수많은 종류의 인공 신경망 중에서 완전연결 신경망Fully Connected Neural Network, FCNN은 모든 뉴런이 이전 층의 모든 뉴런과 연결되는 구조를 가진 인공 신경망이다. 여기서 뉴런이라는 단어가 나오는 이유는 인공 신경망이 인간의 두뇌, 그 중에서도 뉴런과 시냅스의 개념에서 영감을 얻어 만들어졌기 때문이다.
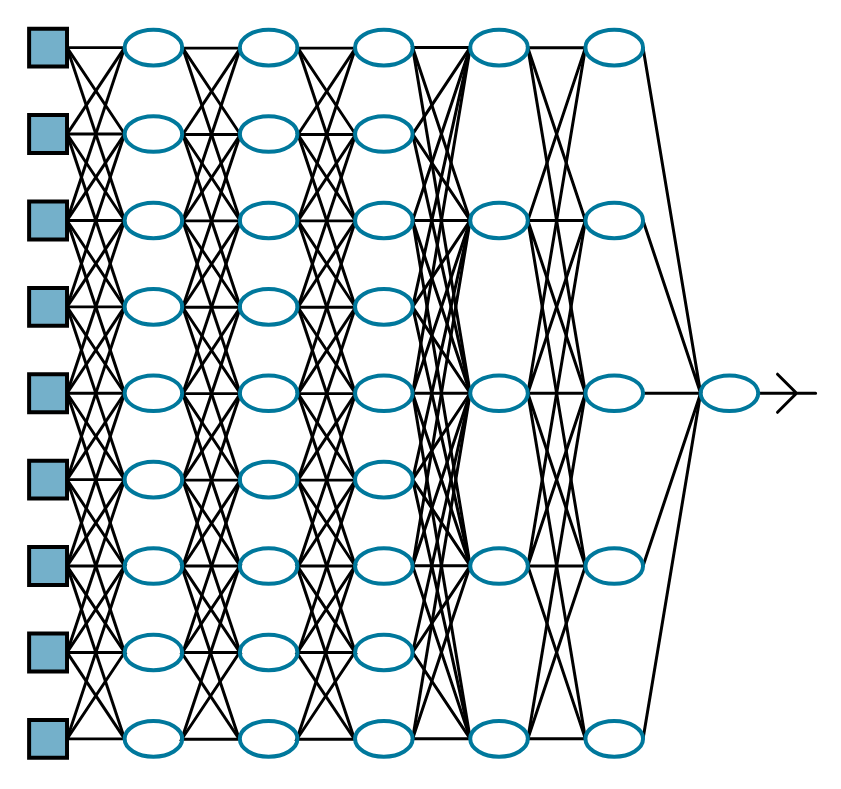 *그림 7. 완전연결 신경망.*
## Perceptron
완전 신경망 내부의 각 개별 뉴런은 인공 신경망의 가장 기본적인 연산 단위인 퍼셉트론의 역할을 수행한다. 이 뉴런은 입력 벡터에 대해 선형 변환Linear Transformation을 수행한 후, 이를 비선형 활성화 함수Non-linear Activation Function에 통과시켜 출력값을 생성한다.
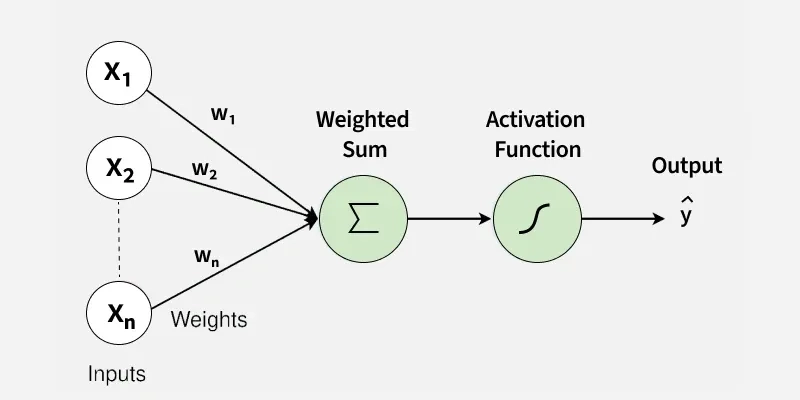 *그림 8. 퍼셉트론을 나타낸 그림.*
특정 계층의 입력 벡터를 , 해당 계층이 보유한 가중치 행렬을 , 편향 벡터를 이라고 할 때, 해당 완전 연결 계층의 출력 은 다음과 같은 수식으로 정의된다.
이 공식에서 는 ReLU(Rectified Linear Unit), Sigmoid, Tanh 등과 같은 비선형 활성화 함수를 나타낸다. 이 선형 변환 수식에서 가중치 행렬 의 개별 원소 는 입력 벡터 의 번째 특성이 출력 벡터 의 번째 뉴런의 활성화 정도에 미치는 독립적인 영향력을 수치화한 것이다. 행렬의 내적 연산을 수행함으로써, 출력 계층의 뉴런 각각은 이전 계층의 전체 입력 데이터로부터 빠짐없이 영향을 받게 된다. 편향 항(Bias Term)인 는 수학적 편의를 위해 비선형 함수 내부에서 가산되며, 출력의 활성화 임계값을 조정하는 역할을 수행한다.
역전파의 발견
퍼셉트론 자체는 1950년대에 만들어졌으나, 1969년 마빈 민스키와 시모어 페퍼트가 <Perceptron>을 통해 단층 퍼셉트론으로는 XOR(배타적 논리합)처럼 직선 하나로 영역을 나눌 수 없는 비선형 문제를 해결할 수 없음을 증명하면서 잊혀졌다. 그런 퍼셉트론이 부활하게 된 계기는 바로 1986년에 데이비드 루멜하트, 제프리 힌튼, 로날드 윌리엄스가 대중화시킨 역전파Backpropagation 학습법 덕분이다. 퍼셉트론의 창시자인 프랭크 로젠블랫도 이미 역전파라는 아이디어를 고안했지만, 여러 개의 계층을 가진 일반적인 다층 퍼셉트론을 학습시킬 수 있는 완성된 형태가 아니었고, 1986년까지도 완성하지 못했던 상태였다.
역전파 알고리즘 덕분에 일반적인 다층 퍼셉트론을 효과적으로 학습시킬 수 있게 됐고, 이에 따라 딥러닝이라는 분야가 본격적으로 시작되었다. 완전연결 신경망은 이때 만들어진 딥러닝 초기의 모델이다. 그렇다면 완전연결 신경망은 기존에 컴퓨터 비전이 가지고 있던 문제들을 해결했을까? 그렇지 않다.
FCNN의 한계
FCNN은 층과 층 사이의 모든 뉴런이 서로 연결되어 있다는 특징을 지니고 있는데, 이러한 전역적 구조의 가장 큰 특징은 입력 데이터의 특성Feature 간의 상호작용이나 위상 수학적 구조에 대해 어떠한 사전 가정도 배제한다는 점이다. 다시 말해, 입력 벡터 내에서 공간적으로 인접하게 위치한 두 특성이 서로 밀접한 관련이 있는지 혹은 서로 아무런 연관성이 없는 완전히 독립적인 정보인지에 관계없이 완전 연결 계층은 모든 특성 조합을 수학적으로 동일하게 취급한다. 이는 FCNN이 데이터의 내재적 구조를 구별하지 않는 범용적인 모델이라는 것을 의미하지만, 반대로 공간적 패턴이 핵심인 영상 데이터를 다룰 때는 비효율성을 야기하는 원인이 되기도 한다.
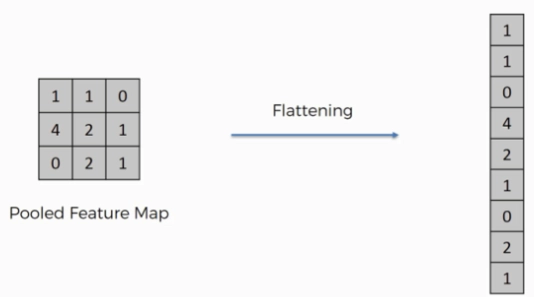 *그림 9. 평탄화(Flattening) 과정을 나타낸 그림.*
CNN이 등장하기 전에는 FCNN과 같은 다층 퍼셉트론으로 이미지를 다뤘는데, 2차원 이미지를 1차원으로 평탄화한 다음 활용했기 때문에 결과적으로 입력되는 이미지의 크기를 곱해준만큼의 파라미터가 필요해 해상도가 조금만 커져도 학습해야 할 가중치 개수가 수백만~수억 개로 폭증하여 연산 자원이 고갈되고 과적합과 싸워야했으며, 이미지의 위치 정보가 사라지기 때문에 연산을 통해 도출된 정확도 또한 기대에 못미쳤다.
Convolutional Neural Network
CNN의 등장
얀 르쿤(Yann LeCun)의 이름이 이 지점에서 등장한다. 당시 그가 속했던 벨 연구소에서는 미국 우체국에서 수필로 쓰던 우편 번호를 디지털화하는 과제를 맡았는데, 이때 그는 사람이 직접 특징 추출기Feature Extractor를 짜는 대신 역전파를 통해 데이터로부터 필터 자체를 학습시키는 아이디어와 허벨과 비젤이 발견한 시각 피질의 생물학적 구조를 신경망의 구조적 제약Inductive Bias으로 걸어 FCNN의 문제를 해결하자는 아이디어를 결합했다.
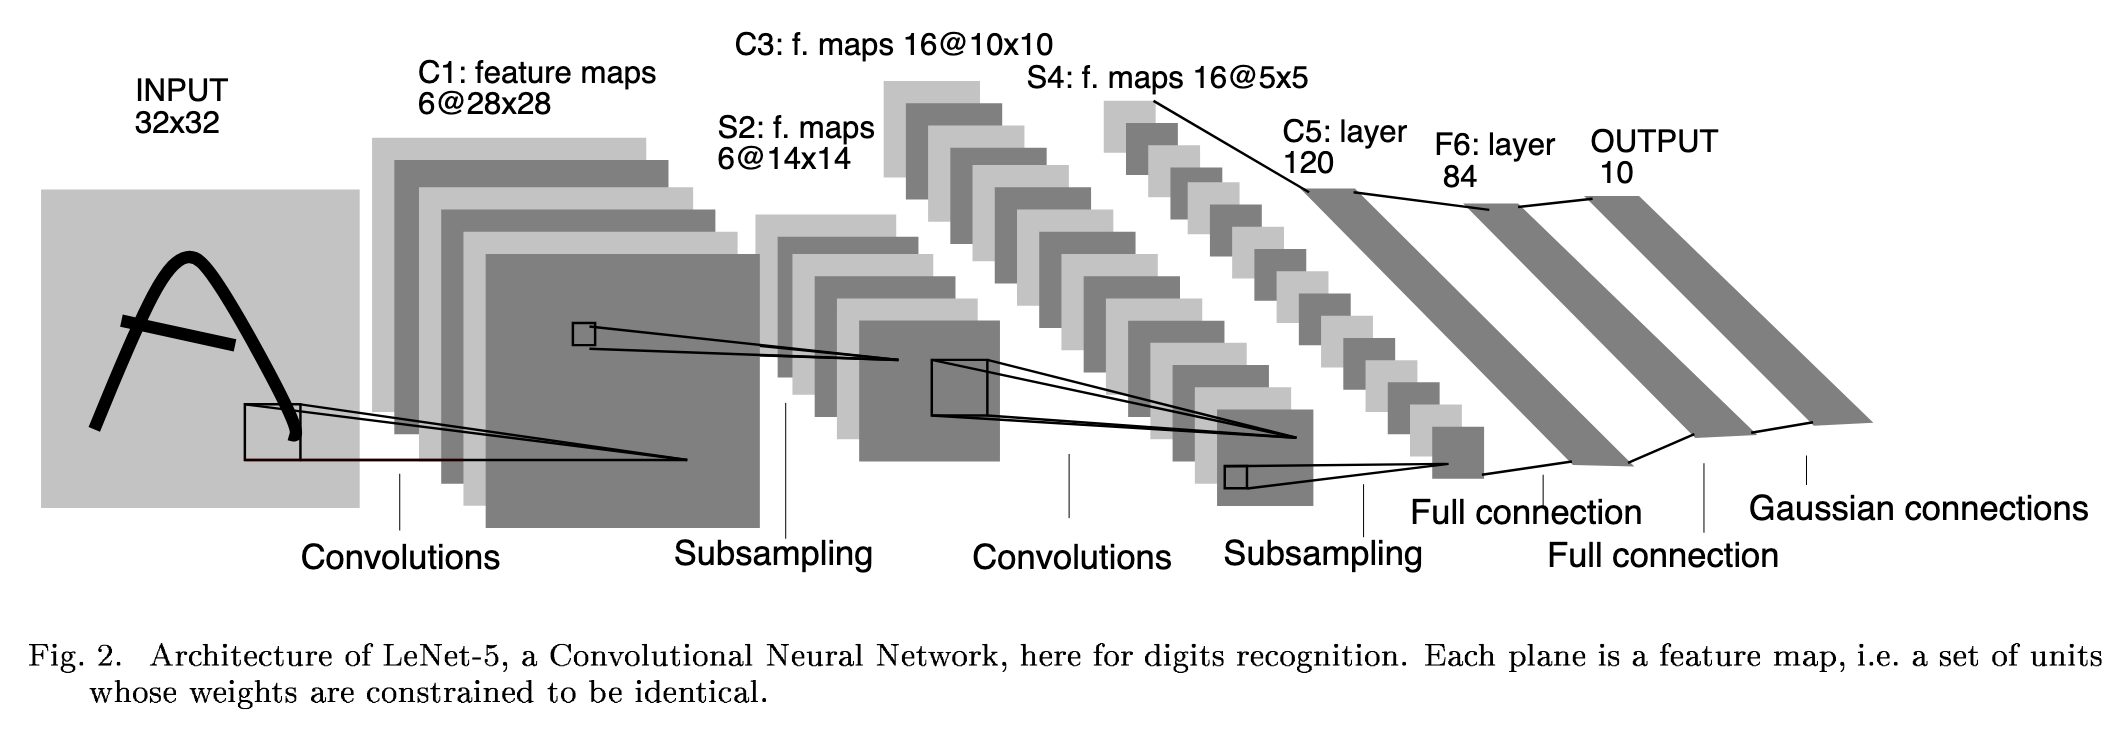 그림 10. LeNet-5 모델의 아키텍처를 나타낸 그림.
<Backpropagation Applied to Handwritten Zip Code Recognition>과 <Gradient-Based Learning Applied to Document Recognition>을 통해 합성곱 신경망Convolutional Neural Network, CNN이 탄생했으며, 이를 기반으로 개발된 제프리 힌튼(Geoffrey Hinton) 교수 연구실의 AlexNet이 2012년 딥러닝 붐을 일으키며 이 두 논문은 AI 발전을 이끌어낸 기념비적인 논문이 됐다. 그렇다면 CNN은 과연 어떤 모델일까? 그 구조를 본격적으로 파헤쳐보자.
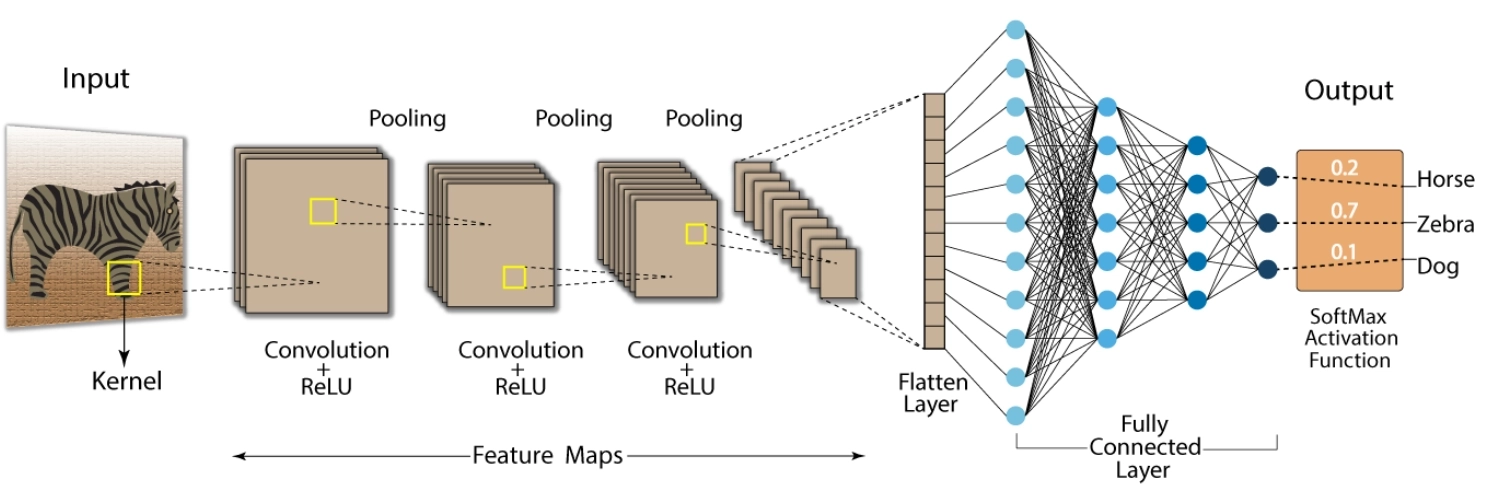 그림 11. CNN의 구조를 간략하게 나타낸 그림.
합성곱 신경망은 텍스트, 음성, 영상, 동영상 데이터 등 1차원 이상의 시공간적 토폴로지를 가지는 다차원 격자 형태의 데이터를 처리하기 위해 생물학적 메커니즘을 모방하여 고안된 특수 목적의 아키텍처이다. CNN은 동물의 시각 피질이 작동하는 방식에서 직접적인 영감을 받았으며, 개별 뉴런이 전체 시야를 한 번에 인지하는 것이 아니라 특정 국소 영역의 자극에만 반응한다는 사실을 차용하였다.
완전연결 신경망이 모든 입력 뉴런과 출력 뉴런을 밀집하게 연결하는 것과 대조적으로, 합성곱 신경망은 희소 연결 전략을 채택한다. 합성곱 계층의 출력 뉴런은 이전 계층의 전체 데이터가 아닌 오직 수용 영역Receptive Field이라 불리는 작고 제한적인 영역에만 연결된다. 이러한 방식으로 신경망은 복잡도를 대폭 낮추면서도 에지나 코너와 같은 공간적 특징을 효율적으로 탐지할 수 있다.
Convolution
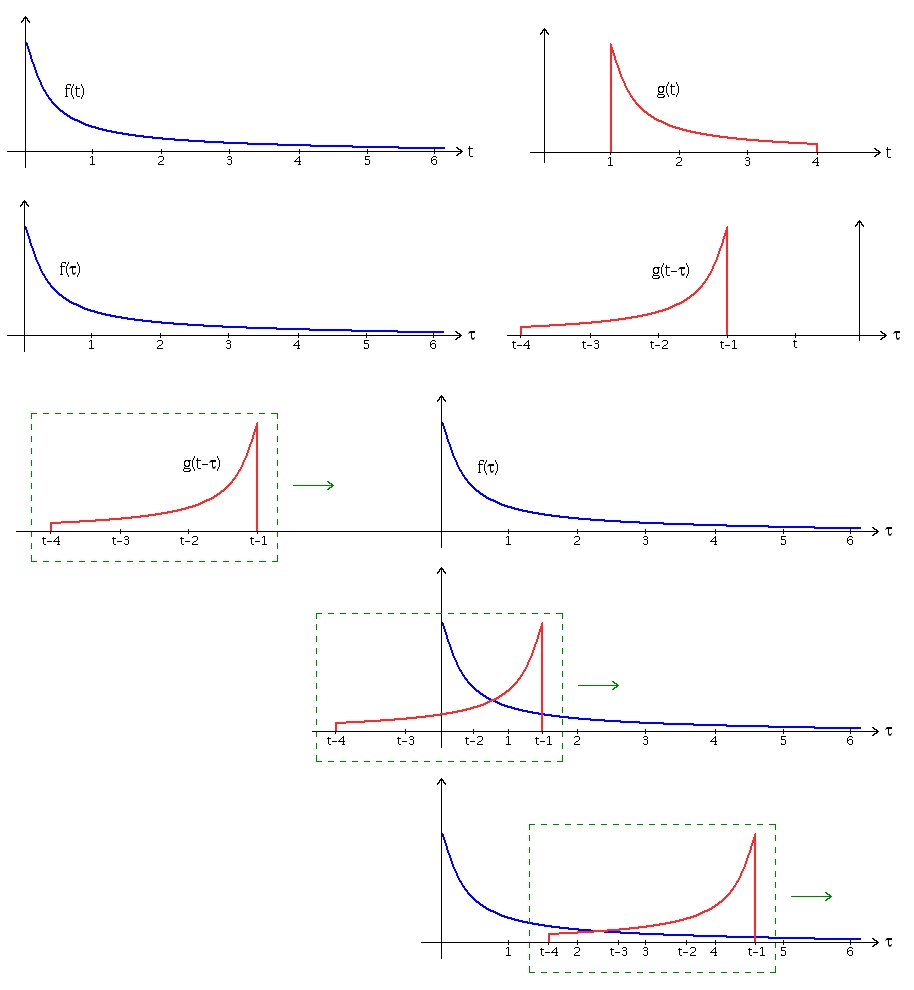 *그림 12. 컨볼루션의 과정을 나타낸 그림.*
합성곱 계층의 핵심 연산은 필터 또는 커널이라 불리는 작고 학습 가능한 3차원 가중치 행렬을 입력 볼륨의 공간적 차원(너비와 높이)을 따라 미끄러지듯 이동시키며 내적 연산을 수행하는 것이다. 이 연산은 다음과 같이 정의된다. 연속적인 공간에서는 (1)로 정의되며, 이산적인 영역에서는 (2)로 정의된다.
각 시점의 입력에 대한 출력은 해당 입력 시점부터 시간에 따라 변화하며 나타나게 되므로 특정 시점 의 총출력량은 해당 시점의 입력에 대한 출력뿐만 아니라 이전 시점의 입력들에 대한 출력들이 중첩해서 나타나게 된다. 따라서 이를 계산하기 위해서 입력과 출력 간의 관계를 통해서 전체 출력을 시간에 따라 표현할 수 있어야 하는데 이를 위해 사용하는 연산이 합성곱이다.
합성곱이 필요한 이유
실생활에서 시각적으로 받아들이는 이미지, 영상 정보들은 모두 픽셀이라는 단위를 가지며, 빛의 3원색으로 알려진 빨간색, 초록색, 파란색 픽셀 정보가 담겨져 있다. 이를 RGB 채널이라 부른다. 이미지는 앞서 설명한 채널 정보는 물론, 일정한 크기의 너비와 높이를 가진다.
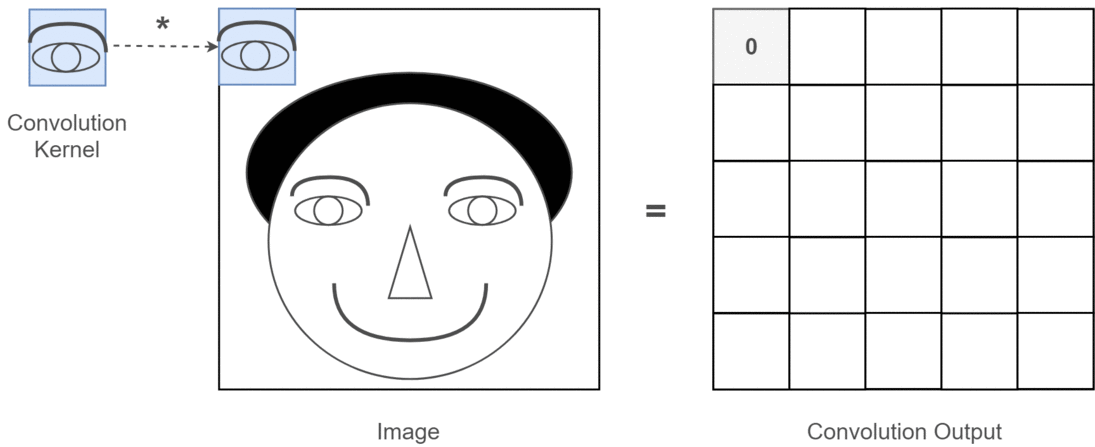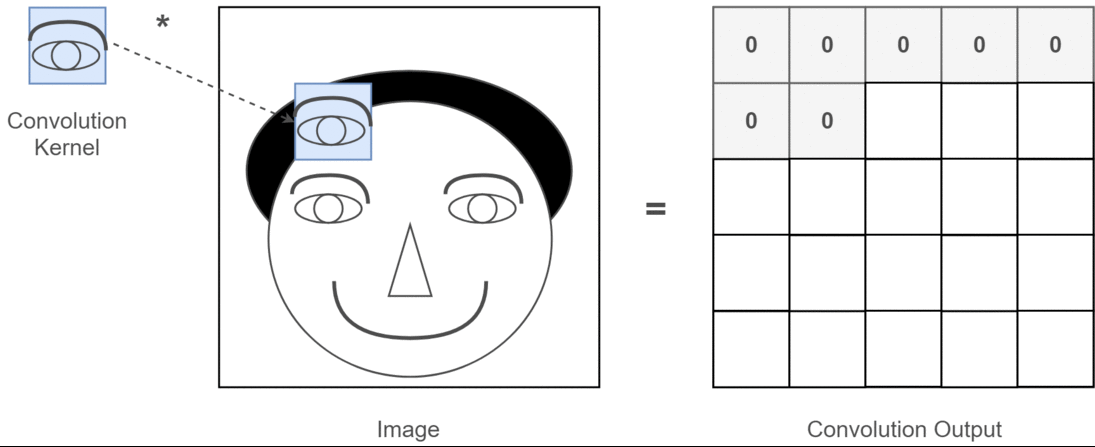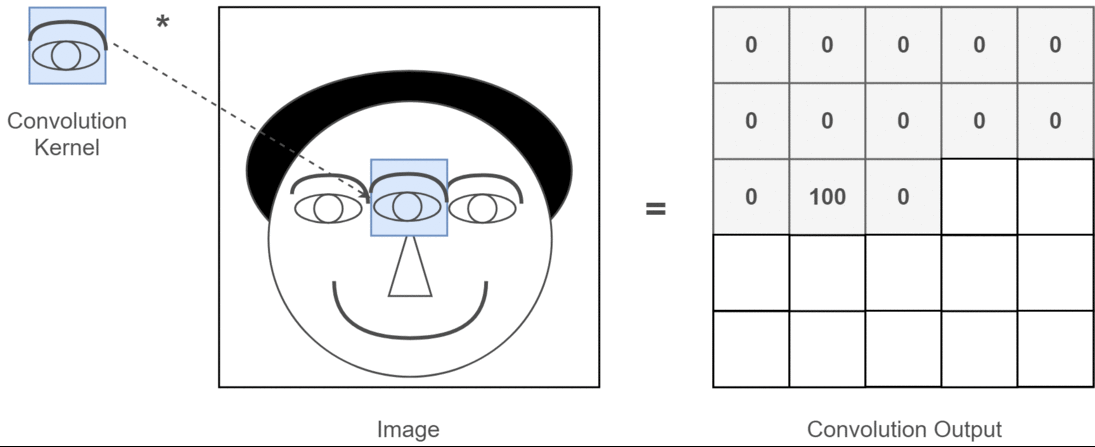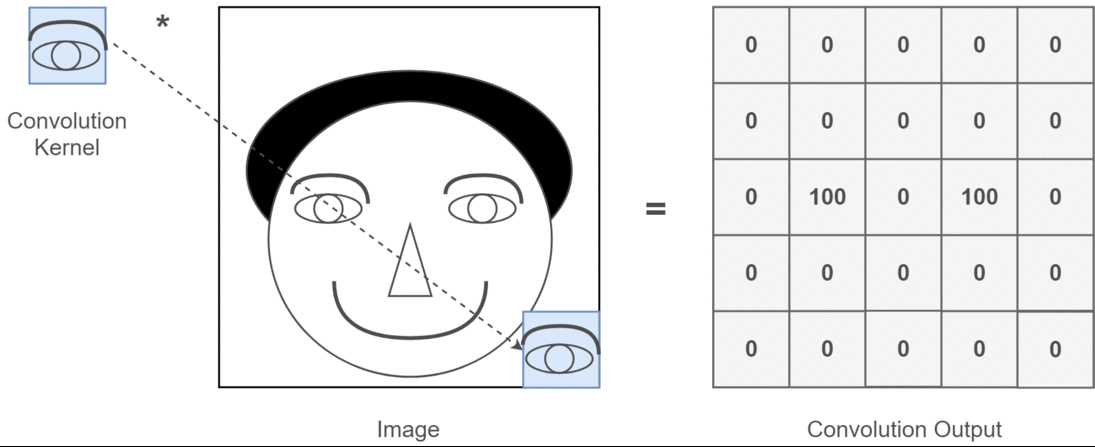 *그림 13. 이미지에 대한 합성곱 연산이 특정 패턴을 감지하는 방법.*
CNN은 이미지를 가로, 세로, 대각선, 곡선 등 수많은 요소로 분해하며 학습하는데, 이때 각 요소에 일치하는 영역만 통과시키는 필터가 계층이 깊어지면서 이미지에 맞게 변화한다. 자세히 보면 이미지에 특정 패턴이 존재하는지 확인하기 위해 필터로 이미지를 스캔하며 유사도를 확인하는 것을 볼 수 있는데, 이 유사도를 계산하기 위한 개념이 바로 합성곱이다.
초기 계층이 선형 경계나 단순한 색상 대비와 같은 저수준 특징을 추출하는 데 그친다면, 이어지는 후속 계층들은 이러한 단순한 특징들을 비선형적으로 재조합하여 복잡한 질감이나 십자 모양, 둥근 곡선 등을 파악한다. 그리고 신경망의 가장 깊은 계층에 도달하면 네트워크는 개, 자동차, 얼굴 등과 같이 의미론적으로 고수준의 계층적 특징이나 사물 객체의 부분을 활성화하는 데 특화된다. 완전 신경망이 입력 벡터에 대한 단일한 비선형 변환을 통해 평면적으로 학습하는 반면, CNN은 이처럼 필터의 중첩을 통해 복잡성을 점진적으로 높여가는 계층적 학습 능력을 발휘한다.
Convolution Layer
크기가 인 3차원 입력 볼륨이 주어졌을 때, 합성곱 계층을 통과하여 새롭게 생성되는 출력 볼륨의 크기 는 다음과 같은 공식에 따라 엄밀하게 계산된다 :
출력 볼륨의 깊이 차원인 는 적용된 필터의 개수 와 정확히 일치한다. 수학적 관점에서 볼 때, 입력 볼륨 에 대해 번째 필터 를 적용하여 출력 볼륨(특징 맵)의 특정 위치 에서 계산되는 활성화 값 는 3차원 공간에서의 요소별 곱의 합과 편향 의 가산으로 구성되며 다음과 같이 전개된다.
 *그림 14. 합성곱 계층에서 연산이 이루어지는 과정.*
이 수식이 의미하는 바는 CNN의 출력 유닛이 입력 데이터 내에서 필터 크기에 해당하는 영역 내부의 정보만을 수용하여 활성화된다는 것이다.
Pooling Layer
하지만 합성곱 연산만 계속한다고 해서 필터가 이미지를 효과적으로 분석할 수 있는 것은 아니다. 이미지의 크기가 유지된다면 많은 연산량을 계속 갖게됨은 물론이며, 정보는 점점 깊어지는데 표현력은 그대로이니 파라미터는 결국 과적합되는 방향으로 학습된다.
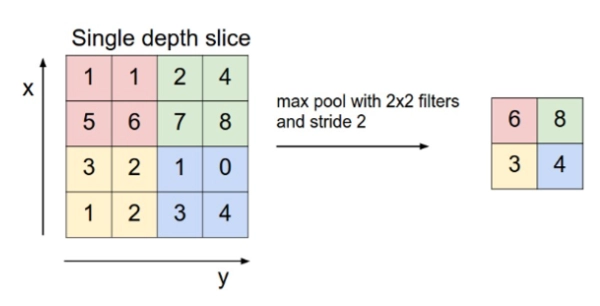 *그림 15. 풀링 계층이 정보를 압축하는 과정.*
그래서 합성곱 연산을 통해 나온 산출물을 압축하는 계층이 바로 풀링 계층(Pooling Layer)이다. 이 계층에는 학습되는 값이 없으며, 필터 크기 내 픽셀 값을 활용한 연산을 수행한다. 간단히 말해 필터를 통해 검출된 값 중에 이미지를 더 잘 표현할 수 있는 값만을 남기는 원리다.
Fully Connected Layer
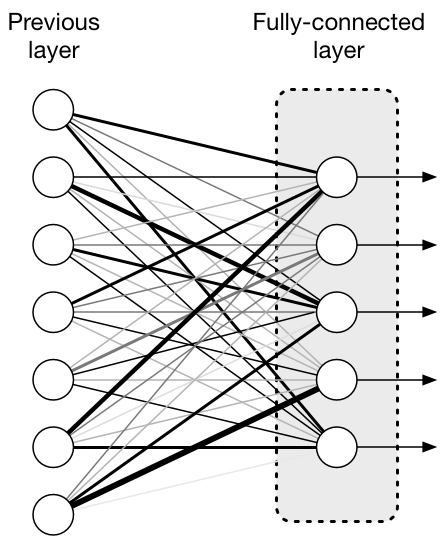
CNN의 계층은 합성곱 계층과 풀링 계층이 번갈아 배치된 영역과 완전 연결 계층Fully Connected Layer의 영역으로 구분할 수 있는데, 합성곱 계층과 풀링 계층이 특성을 추출하기 위한 것이라면 완전 연결 계층는 분류를 위한 것이다.
FCNN vs CNN
CNN은 FCNN의 문제를 해결하기 위해 등장했지만, 그렇다고 해서 CNN이 모든 상황에서 FCNN에 비해 우위인 것은 아니다. 연결 방식이 다르기 때문에 그로 인해 파라미터의 변화도 다르게 나타나며, 가중치 공유 여부, 메모리 비용 및 연산 복잡도, 과적합 취약성도 모두 다르게 나타난다. FCNN과 CNN을 표로 비교하면 다음과 같다.
| 네트워크 구성 특성 | 완전 신경망 (FCNN 계층) | 합성곱 신경망 (CNN 계층) |
|---|---|---|
| 뉴런 연결 방식 | 밀집(Dense); 이전 층의 모든 노드와 연결 | 희소(Sparse); 국소 수용 영역 내 정보만 수신 |
| 파라미터 증감 의존성 | 데이터의 입력 해상도 차원에 완벽히 종속됨 | 입력 해상도와 무관, 채널 수 및 필터 크기에 종속 |
| 가중치 공유 여부 | 전혀 없음; 각 연결선마다 독립적 가중치 보유 | 존재함; 특정 위치의 필터 파라미터를 전체 평면에 적용 |
| 메모리 비용 및 연산 복잡도 | 과도한 연결로 인한 높은 비용 및 메모리 고갈 위험 | 효율적인 곱셈 연산 구조로 컴퓨팅 자원 대폭 절약 |
| 과적합 취약성 | 방대한 파라미터 공간으로 인해 매우 취약함 | 공유 메커니즘 자체가 정규화 효과 제공 |
FCNN은 특성 간에 공간적, 시간적, 구조적 배열이 존재하지 않고 각각의 열이 독립적인 정보를 담고 있는 표 형식의 정형 데이터에서 가장 뛰어난 성능을 발휘한다. 신용 리스크 평가를 위한 금융 데이터나 환자의 임상 수치 측정 데이터와 같이 나이, 소득, 혈압, 체중 등 서로 상이한 속성을 지닌 변수들 간에는 물리적인 위치 개념이 무의미하다. 이러한 데이터의 피처 열의 순서를 뒤섞더라도 내재된 정보량은 훼손되지 않는다.
만약 표 형식 데이터에 억지로 CNN을 적용한다면 상관관계가 전혀 없는 '체중'과 '소득' 같은 인접한 열에 대해 억지로 지역적 공간 패턴을 찾으려는 논리적 모순에 빠지게 되어 모델 성능이 크게 훼손된다. FCNN은 이러한 제약 없이 모든 변수들 간의 복잡한 비선형 전역 상호작용을 자유롭게 탐색할 수 있어 정형 데이터 분석, 단순 회귀 분석, 구조화되지 않은 일반적인 분류 태스크에서 압도적인 효율성을 입증한다.
초기에 2차원 이미지를 분석하기 위해 고안된 CNN은 가중치 공유 및 국소적인 특징 추출이라는 강력한 이론적 이점을 바탕으로 시공간적 토폴로지를 띠는 모든 차원의 데이터로 응용 범위를 확장하였다. 시계열 형태를 띠는 센서 신호 트렌드, 음성 파형 분석, 주식 시장의 흐름 예측, 자연어 처리(NLP) 분야의 텍스트 토큰 시퀀스, 일반적인 흑백, 컬러 이미지 인식 작업이나 초음파, MRI, CT 볼륨 스캔과 같은 공간적 입체 데이터나 비디오 영상 클립 분석 등의 영역에서 널리 활용된다.
참고 (출처)
- https://velog.io/@not12m10/Convolution의-개념과-연산에-대하여
- https://people-analysis.tistory.com/264
- https://m.blog.naver.com/ycpiglet/222556985523
- Roberts, L.G. (1963) Machine perception of three-dimensional solids. Massachusetts Institute of Technology.
- Robertson, B. (2009) ‘A celebration of the 50th anniversary of David Hubel and Torsten Wiesel’s Receptive fields of single neurones in the cat’s striate cortex’, The Journal of Physiology, 587(12), pp. 2721–2732.
- LeCun, Y. et al. (1989) ‘Backpropagation Applied to Handwritten Zip Code Recognition’, Neural Computation, 1(4), pp. 541–551.
- Lecun, Y. et al. (1998) ‘Gradient-based learning applied to document recognition’, Proceedings of the IEEE, 86(11), pp. 2278–2324.
- Russell, S.J. and Norvig, P. (2021) Artificial Intelligence: A Modern Approach, Global Edition. 4th edn. Pearson.
- Fukushima, K. (1980) ‘Neocognitron: A self-organizing neural network model for a mechanism of pattern recognition unaffected by shift in position’, Biological Cybernetics, 36(4), pp. 193–202.